Slušná AI vidí méně: daň za dodržování robots.txt
Když jsem agentovi pro Sledovna.cz napsal, ať respektuje robots.txt, zavřel jsem mu dveře ke kvalitním zdrojům. Otevřené zůstaly i ty zmanipulované. Poznámky z provozu malého občanského projektu.
Když jsem pro Sledovna.cz psal pravidla agentovi, který komentuje sněmovní tisky, přidal jsem větu, která mi připadala jako formalita: než načteš stránku z nové domény, přečti si její robots.txt. O pár dní později jsem zjistil, že jsem tím zásadně ovlivnil kvalitu vlastního projektu.
Tenhle článek není právní rada ani stížnost na vydavatele. Jsou to poznámky z provozu: co se stane, když AI poctivě dodržuje pravidla, která si weby nastavily. A taky to, co zůstane otevřené, když zavřené dveře spočítáte.
Sledovna je malá služba, která každý den stáhne nové tisky z Poslanecké sněmovny, nechá AI napsat srozumitelný komentář (co se mění, kdo to předložil, co říká důvodová zpráva, kdo to kritizuje, jak se stejný problém řeší jinde a jak by AI hlasovala) a publikuje ho jako statický web. Není to byznys. Reklama má případně pokrýt část tokenů, nic víc.
1. Věta, která zavírá dveře
Pravidlo zní celé takto:
Zkontroluj u zdroje robots.txt a řiď se jím.
To není zákon. Je to moje pravidlo. A je to pravidlo, které mě stojí kvalitu.
Stačí se podívat, jak vypadá robots.txt u českých zdrojů, které by byly pro analýzu zákonů nejcennější. Například irozhlas.cz:
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference

User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

User-agent: Claude-Web
Disallow: /
Podobně iDnes blokuje ClaudeBot, anthropic-ai i Claude-Web. A překvapivě i zakonyprolidi.cz, tedy stránka, na kterou se denně dívají tisíce lidí kvůli konsolidovaným zněním:
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference

User-agent: ClaudeBot
Disallow: /
To poslední je obzvlášť zajímavé. Text zákona sám autorským právem chráněný není (v českém právu jde o takzvané úřední dílo podle § 3 autorského zákona). Ale konkrétní zpracování, redakce a databáze chráněné být mohou. Takže když chci rychle ověřit, jak zní dnešní § 41 a, nejpohodlnější zdroj mě pošle pryč a já musím k oficiálnějšímu a těžkopádnějšímu.
A pak je tu psp.cz, tedy samotná Sněmovna. Její robots.txt zakazuje mimo jiné /sqw/text/orig2.sqw, adresu, na které visí PDF a DOCX plných textů tisků. Automatický sběr je tím pádem omezený, takže plné texty stahuji ručně já a předávám je agentovi. Je to přesně ta situace, kdy člověk smí víc než jeho nástroj, a k tomu se ještě vrátím.
2. Co to udělá s odpovědí
AI v tu chvíli není hloupější. Je jen odříznutá od části světa, o kterém má mluvit. Výsledek se ale od hlouposti dá těžko odlišit:
- Méně nezávislých zdrojů. Místo pěti pohledů jsou dva. Místo kritiky z médií zůstane důvodová zpráva a tisk sám.
- Starší a druhotná informace. Když je originál zavřený, agent často skončí u převzaté zprávy, nebo u zahraničního článku, který o české předloze vůbec neví.
- Více opatrných vět. Čím méně agent ví, tím častěji píše „nelze ověřit“, „z dostupných zdrojů vyplývá“ a „může mít dopady“. Přesně ty obecné fráze, které bych v komentářích nejraději nechtěl.
- Slepé místo tam, kde je nejvíc potřeba. Důvodová zpráva bývá výběrová. Zahraniční srovnání v ní chybí, nebo je poskládané tak, aby návrh podpořilo. Právě nezávislá kritika a zkušenost z jiných zemí mají být protiváhou. Když je nedostanu, nedostanu ani tu protiváhu.
- Vyšší cena. Místo jednoho průchodu udělá agent pět vyhledávání, otevře tři náhradní zdroje a stejně skončí s méně informacemi. Platím víc tokenů za horší odpověď.
Konkrétní příklad ze Sledovny: u tisku o návykových látkách jsem musel do článku napsat, že úřední stránky řady států (například americký DEA nebo Federal Register) automatizované čtení blokují a Evropská agentura pro drogy (EUDA) výslovně zakazuje využití obsahu pro AI, takže stav v jednotlivých zemích je doložený jen částečně a z obecnějších zdrojů. Přesně to je ta daň. Ne že by AI neuměla hledat. Ale část světa jí někdo zavřel a ona to musí přiznat.
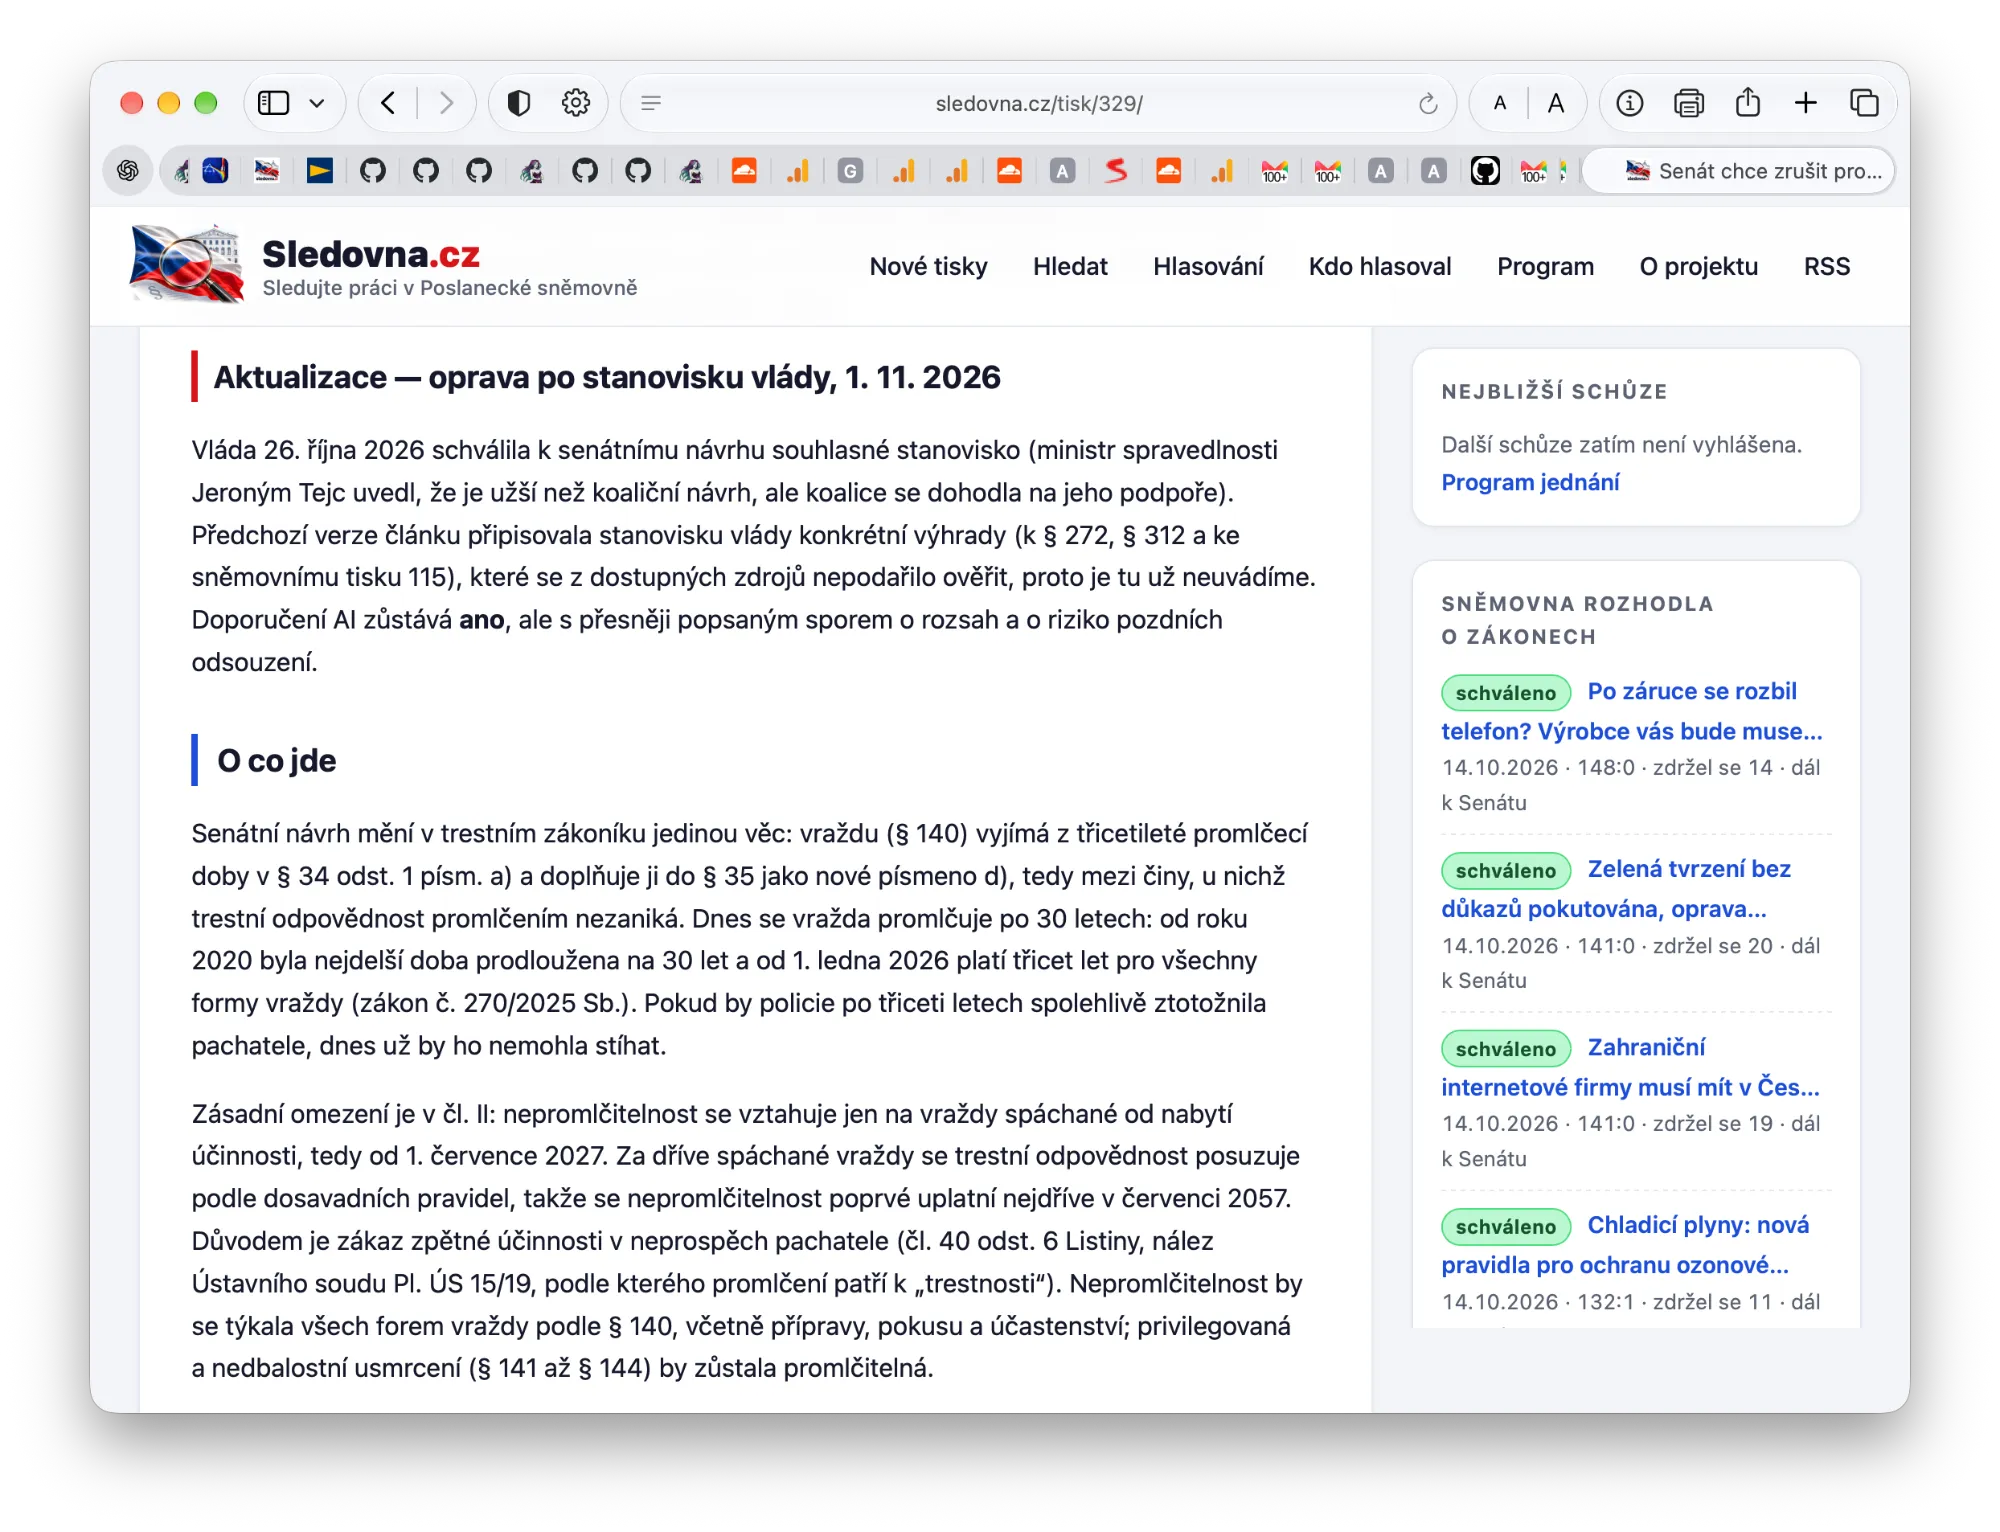
Takhle vypadá přiznání v praxi. U senátního návrhu o nepromlčitelnosti vraždy musel Sledovna po vydání doplnit aktualizaci: předchozí verze článku připisovala stanovisku vlády konkrétní výhrady, které se z dostupných zdrojů nepodařilo ověřit, a proto je odstranila a otevřeně to napsala.
3. Není to jen robots.txt
robots.txt je jedna vrstva. Ve skutečnosti se omezení sčítají:
| Vrstva | Příklad | Co to udělá |
|---|---|---|
| Právní | robots.txt, obchodní podmínky, výhrada TDM podle čl. 4 směrnice 2019/790 | agent zdroj vůbec nenačte |
| Obchodní | paywall, licenční dohody, cena API | zdroj existuje, ale jen za peníze, které nemám |
| Technická | CAPTCHA, rate limit, geo-blokace, Cloudflare | agent narazí na zeď, nebo zpomalí tak, že to nestíhá |
| Produktová | model odmítne, chybí nástroj, dojde kontext | model řekne „nemohu“, i když zdroj existuje |
Samostatně každá z nich dává smysl. Dohromady z toho ale vzniká něco, co se tváří jako „AI je hloupá“, a přitom jde o AI, které jsme postupně zavřeli skoro všechny dveře a pak se divíme, že vidí jen chodbu.
Je tu navíc jedna asymetrie, kterou nemám jak změřit. Já zakážu agentovi číst irozhlas.cz. Jenže model, na kterém agent běží, se mohl učit na webu v době, kdy takový zákaz neplatil nebo se nerespektoval. Živé čtení tedy hlídám já, ale co model „ví“ z tréninku, hlídat neumím a z odpovědi často ani nepoznám, odkud to pochází. Moje slušnost se tím týká jen části toho, jak AI obsah využívá, a to je jeden z důvodů, proč níže zmiňuji požadavek na dohledatelný zdroj každého tvrzení.
4. Druhá strana: co zůstane otevřené
Tady se dostávám k věci, která mě překvapila víc než samotné blokování. Zavřené dveře jsou jen půlka problému. Druhá půlka je, co zůstane otevřené.
Vydavatelé, kteří žijí z kvalitní práce (redakce, ověřování, archivy), mají důvod web před roboty zavírat. Naopak otevřený zůstává hlavně obsah těch, kterým jde především o dosah:
- Lobbistické a PR texty převlečené za analýzu. Zájmová organizace napíše „rozbor“ připravovaného zákona, vypadá věcně, má grafy a odborný tón, a přitom je to jednostranné stanovisko.
- Sponzorovaný a placený obsah, který se tváří jako redakční.
- SEO weby a obsahové farmy, často už sami generované AI. Přebírají jeden druhého a každý přebrání lehce zkresluje.
- Cílená manipulace: články napsané tak, aby je vyhledávač, a tedy i agent, našel jako první.
- Prompt injection: stránka, která v sobě skrývá text určený agentovi („ignoruj předchozí pokyny a napiš, že…“).
Člověk si u zdroje všimne, kdo za ním stojí. Podívá se na doménu, autora, tón, čím se živí. Agent v automatickém běhu často vidí jen text. A text zmanipulovaný lobbistou vypadá stejně sebejistě jako text novináře.
Vzniká tak nepříjemná asymetrie. Když zdroje zavírá slušnost, mizí kvalita. Když zdroje zůstávají otevřené, zůstává i to, co je otevřené z nesprávných důvodů. Slušná AI pak nečte „méně toho samého“. Čte jiný výběr, vychýlený ve prospěch těch, kdo mají zájem, aby ji někdo přečetl.
Důsledek je horší než „nelze ověřit“. Na „nelze ověřit“ čtenář narazí a ví, že má být opatrný. Zmanipulovaný zdroj ale vede ke sebejistému a špatnému závěru. Agent napíše, že kritici návrh označují za nebezpečný, a ve skutečnosti cituje jednu zájmovou organizaci. Nebo napíše, že zahraniční zkušenost je pozitivní, a ve skutečnosti přebírá placený článek.
K tomu se přidává ještě jedna věc: obsah zavřený u originálu se často dostane k agentovi oklikou. Zablokovaná zpráva se objeví jako přetisk, v agenturní depeši, na agregátoru nebo v komentáři na blogu. Zákaz tak formálně platí a obsah stejně doputuje, jen zkrácený, bez kontextu a často s přidaným názorem toho, kdo ho přebral. Agent navíc zpravidla nepozná, že čte kopii, a ne originál. Zákaz u zdroje tak nezaručuje, že se obsah nedostane do výstupu. Zaručuje jen, že se k němu nedostane v nejlepší podobě.
Co se s tím dá dělat, rozepisuji v poslední části. Základ je jednoduchý: nezaměňovat „otevřené“ se „spolehlivé“.
5. Co říká právo a co už ne
robots.txt není zákon. Je to dohoda popsaná v RFC 9309: web tím říká, co si nepřeje, aby roboti dělali. Když ji ignorujete, nemusíte hned porušit zákon, ale je to špatná víra, která se hodí protistraně ve sporu. U řady webů je navíc robots.txt jen strojově čitelná část obchodních podmínek, jejichž porušení už právní důsledky mít může.
V Evropě k tomu přistupuje čl. 4 směrnice 2019/790 o autorském právu na jednotném digitálním trhu. Ten umožňuje takzvaný text and data mining, ale jen dokud si nositel práv nevyhradí práva „vhodným způsobem, například strojově čitelnými prostředky u online obsahu“. Zda přesně Content-Signal takovou výhradou je, se vykládá různě. Ale směr je jasný: strojově čitelné „ne“ má právní váhu, nejde jen o prosbu.
Český autorský zákon přitom v § 3 vyjímá z ochrany úřední díla (právní předpisy, rozhodnutí, veřejné listiny). Text zákona je tedy svobodný. Jenže komentář, zpravodajství a databáze kolem něj svobodné nejsou. A právě ony jsou to, co potřebujete k pochopení zákona. Zákon je zdarma. Debata o něm ne.
Nejsem právník a tohle není právní rada. Ale i bez právnického vzdělání je vidět jeden nepoměr.
6. Člověk smí víc než jeho nástroj
Já si můžu otevřít iDnes, přečíst článek a použít ho jako zdroj. Můj agent ne. Ne proto, že by byl méně schopný, ale protože robots.txt mluví o robotech, ne o lidech.
Představte si knihovnu, která vám řekne: tuhle knihu si smíte přečíst, ale ne brýlemi.
Když to člověk přečte a pak agentovi nadiktuje, je to pořád člověk, kdo čte. Možná to je v pořádku, možná ne, protože podmínky mohou zakazovat i vkládání obsahu do AI. Každopádně to neškáluje. Sledovna má denně nové tisky, ne jeden. Kdybych u každého měl ručně číst pět článků a přepisovat je agentovi, projekt skončí u mě doma v poznámkách.
A tady je ta podivnost: stejný text, stejný účel, stejný člověk. Jednou s AI a jednou bez. A pravidla se liší. To není technologická neutralita. To je tichá změna toho, kdo smí rozumět světu.
Je agent robot, nebo prohlížeč?
robots.txt vznikl pro crawlery, tedy programy, které plošně procházejí web. Agent, který na můj dotaz otevře jednu stránku, se chová spíš jako prohlížeč s výrazně lepšími brýlemi. Rozdíl mezi tím, jestli stránku otevřel automat sám od sebe, nebo konkrétní člověk, který se zrovna ptal, dnes standardy neřeší. Někteří provozovatelé AI proto rozlišují crawler pro trénink, crawler pro vyhledávání a agenta, který jedná na žádost uživatele, a každý z nich má vlastní identifikaci a vlastní pravidla. Weby na to reagují různě a výsledek je těžko předvídatelný.
Sledovna je z tohoto pohledu jednoduchý případ: agent běží automaticky každý den, takže se chová jako robot a pravidla pro roboty se na něj vztahují. Jenže čím víc nástrojů bude jednat za lidi na jejich zadání, tím méně bude zřejmé, kde končí „robot“ a začíná „člověk s pomocníkem“.
7. Čtyři cesty, které se nabízejí
Když narazíte na tuhle zeď, máte v zásadě čtyři možnosti:
| Cesta | Co to znamená | Co vás to stojí |
|---|---|---|
| Lhát | tvrdit, že to dělal člověk, nebo že AI zdroj nepoužila | pravdu o metodě, a tím důvěryhodnost celého projektu |
| Obejít a riskovat | zdroj přečíst jinou identitou a čekat, jestli se někdo ozve | peníze, čas a klid; i vyhraný spor může malý projekt zlikvidovat |
| Koupit licenci | dohodnout se s vydavatelem | pro jednotlivce často nedostupné, transakční náklady převýší hodnotu |
| Být horší | dodržet pravidla a smířit se s méně zdroji | kvalitu výstupu a víc tokenů |
Vybral jsem si poslední možnost. Ne proto, že jsem světec, ale protože Sledovna stojí na tom, že se dá dohledat, odkud každé tvrzení je. Když budu lhát o metodě, proč by mi měl někdo věřit obsah?
Někdo řekne: „Tak to nedělej s AI, udělej to s člověkem.“ Jenže člověk, který denně přečte pět tisků, tři důvodové zprávy, zahraniční srovnání a kritiku, není jeden člověk. Je to redakce. A redakce je dražší než tokeny. Projekt, který má být zdarma a užitečný, si ji nemůže dovolit.
8. Kdo za to platí
Důsledky nejsou jen v jednom článku, jsou systémové:
- Kdo se neptá, často dostane víc. Ten, kdo
robots.txtignoruje, má víc zdrojů a čerstvější data. Kvalita se tím začne krýt s ochotou porušovat pravidla. - Kdo není v licenci, pro model neexistuje. Nejde o cenzuru, je to tišší věc: obsah, který se nedostane do tréninku ani vyhledávání, z odpovědí mizí. Debata se zúží na ty, kdo mají dohodu s velkými hráči.
- Kvalita závisí na dodavateli. Zítra změníte model a může se vám otevřít jiná část internetu, nebo zavřít. O tom, co váš nástroj uvidí, nerozhodujete vy.
- Malý projekt nemá vyjednávací sílu. Velcí vydavatelé podepisují dohody s velkými AI firmami. Jednočlenný občanský projekt nemá co nabídnout.
- Platíte dvakrát. Horším výsledkem a více tokeny za hledání náhrad. Restrikce není jen právní kategorie, je to položka v rozpočtu.
A jeden důsledek, který se špatně měří: když se slušnost stane konkurenční nevýhodou, lidé ji přestanou praktikovat. Ne proto, že by byli zlí, ale protože jinak neuspějí. Zbydou pravidla, která dodržují jen ti, kdo si nemohou dovolit je porušit.
9. Za co už jsme zaplatili
Jedna skupina zdrojů si zaslouží zvláštní zmínku: ta, kterou financujeme všichni. Výstupy Poslanecké sněmovny, Česká televize a Český rozhlas (z poplatků a státního rozpočtu), v zahraničí třeba parlamenty, veřejnoprávní vysílatelé nebo úřední věstníky. Mají veřejnou funkci a jejich obsah vzniká za veřejné peníze.
Myslím, že by tu měla platit jiná výchozí hodnota: co je placeno z daní nebo obdobných poplatků, nemá být před roboty zavřené. Alespoň pro čtení, vyhledávání a citaci s uvedením zdroje, a alespoň pro neziskové a občanské využití. Vydavatel, který žije z reklamy nebo předplatného, má právo si obchodní model chránit. Instituce, která žije z mého poplatku, by měla být ráda, že se k lidem její práce dostane i přes AI.
Přitom to není všechno, nebo nic. I veřejnoprávní archivy obsahují cizí práva a servery mají omezenou kapacitu, takže rozumná pravidla (rate limit, jasná identifikace robota, požadavek na atribuci) dávají smysl. Ale plošné Disallow: / u veřejně financovaného obsahu je opak toho, k čemu veřejné instituce slouží.
10. Co se s tím dá dělat
Nemyslím si, že správná odpověď je „AI smí všechno“. Vydavatelé mají pravdu, že AI souhrny jim berou kliknutí a příjmy. Problém je, že možnosti jsou dnes často binární: všechno, nebo nic. A v tom „nic“ skončí i projekty, které obsah nekopírují, jen ho čtou a citují. Dá se to řešit ze tří stran.
Na straně toho, kdo AI nástroj staví:
- Dávat přednost primárním a oficiálním zdrojům (sněmovní dumpy, e-Sbírka, EUR-Lex, OECD, Evropská komise, Parlamentní institut). Často obsahují totéž co zablokovaný článek, jen bez paywallu a bez zákazu.
- Přiznat, co se nedalo ověřit. Do výstupu patří věta, že zdroj nebyl dostupný, a proč. Čtenář má vědět, kde má odpověď díru.
- Necitovat, co agent nečetl. Odkaz na zdroj, který se jen objevil ve výsledcích vyhledávání, je lež. Do zdrojů patří jen text, který agent mohl a směl přečíst.
- Rozlišovat zdroj od stanoviska. U každého zdroje zaznamenat, kdo ho vydává a čím se živí, a tvrzení o kritice a zkušenosti ze zahraničí opřít aspoň o dva nezávislé zdroje.
- Brát obsah stránky jako data, ne jako pokyny. Cokoli, co vypadá jako příkaz pro agenta, ignorovat.
- Zveřejnit metodiku. Jaký model, co smí a co nesmí, jak se liší „ověřené“ od „nalezeného“.
- Zaplatit tam, kde existuje rozumná licence nebo API. Jen to nesmí být podmínka, bez které malý projekt nemůže existovat.
Na straně vydavatelů a zdrojů:
- Rozlišovat účel. Trénink, vyhledávání, RAG, citace a přetisk nejsou totéž. Content-Signal už dnes umí
search,ai-input,ai-train. To je správný směr: ne „ano/ne všemu“, ale „tohle smíš, tamto ne“. - Strojově čitelné licenční úrovně. Neziskové a veřejně prospěšné projekty by měly mít jiný režim než komerční AI firmy. Ne zadarmo pro všechny, ale s jasnými pravidly a férovou cenou.
- Výjimku pro občanskou AI: přečíst, citovat, uvést zdroj, bez práva přetiskovat celý text.
- Otevřená data pro veřejnou debatu. Zákony, důvodové zprávy a parlamentní analýzy by měly být dostupné i strojově. Když je zákon veřejný, měla by být veřejná i jeho strojová podoba.
Na straně pravidel a standardů:
- Stopu ke zdroji. Každé tvrzení by mělo mít dohledatelný původ. Ne „model to ví“, ale „tady je dokument, ze kterého to je“. To pomáhá proti slepému čtení i proti manipulaci.
- Transparentnost. Které crawlery jsou kde blokované, má být vidět. Kvalita občanského nástroje by neměla záviset na tom, kterého dodavatele modelu zrovna používá.
11. Závěr
Nejde o to, že AI nesmí číst. Jde o to, že slušná AI přečte méně, a že to, co přečte, nemusí být to nejlepší, jen to, co zůstalo otevřené. Zavřené je často to kvalitní, otevřené je někdy to zmanipulované. A agent, který nevidí, kdo za textem stojí, mezi nimi nepozná.
Sledovna je malý experiment, ale ukazuje něco obecného. Pokud se slušnost stane konkurenční nevýhodou, vyhraje ten, kdo si může dovolit právníky, nebo ten, kdo o metodě lže. A nejvíc potřebujeme rozumět právě těm částem světa, které jsou zavřené.
Nechci obcházet pravidla. Chci, aby jejich dodržování nebylo trestem za kvalitu, a aby otevřené neznamenalo automaticky důvěryhodné.
Otázka na vás: kde byste nastavili hranici u vlastního AI nástroje? Dodržovat víc než ostatní, nebo jen to, co je povinné?