La IA educada ve menos: el precio de respetar robots.txt
Cuando le dije al agente de Sledovna.cz que respetara robots.txt, le cerré la puerta a fuentes de calidad. Las que quedaron abiertas incluían también las manipuladas. Notas de la operación de un pequeño proyecto cívico.
Cuando escribí para Sledovna.cz las reglas del agente que comenta los proyectos de ley de la Cámara de Diputados checa (en checo, tisky, es decir, los documentos parlamentarios numerados), añadí una frase que me pareció una simple formalidad: antes de cargar una página de un dominio nuevo, lee su robots.txt. Unos días después descubrí que con ella había influido de forma decisiva en la calidad de mi propio proyecto.
Este artículo no es un consejo jurídico ni una queja contra los editores. Son notas de la operación: qué pasa cuando la IA respeta honestamente las reglas que han fijado los sitios web. Y también qué queda abierto cuando se descuentan las puertas cerradas.
Sledovna es un pequeño servicio que cada día descarga los nuevos proyectos de la Cámara de Diputados, hace que una IA escriba un comentario comprensible (qué cambia, quién lo presenta, qué dice la exposición de motivos, quién lo critica, cómo se resuelve el mismo problema en otros países y cómo votaría la IA) y lo publica como sitio estático. No es un negocio. La publicidad, en todo caso, debería cubrir parte de los tokens, nada más.
1. La frase que cierra las puertas
La regla completa dice así:
Comprueba el robots.txt de la fuente y atente a él.
No es una ley. Es mi regla. Y es una regla que me cuesta calidad.
Basta con mirar cómo es el robots.txt de las fuentes checas que serían más valiosas para analizar leyes. Por ejemplo, irozhlas.cz (el sitio de noticias de la Radio Checa):
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference

User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

User-agent: Claude-Web
Disallow: /
Algo parecido hace iDnes, que bloquea ClaudeBot, anthropic-ai y Claude-Web. Y, sorprendentemente, también zakonyprolidi.cz, la página que miles de personas consultan a diario para ver el texto consolidado de las leyes:
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference

User-agent: ClaudeBot
Disallow: /
Esto último es especialmente interesante. El texto de la ley en sí no está protegido por derechos de autor (en el derecho checo se trata de las llamadas “obras oficiales”, según el § 3 de la ley checa de derechos de autor). Pero la elaboración concreta, la redacción editorial y las bases de datos sí pueden estar protegidas. Así que cuando quiero comprobar rápidamente qué dice hoy el § 41 a, la fuente más cómoda me manda a paseo y tengo que acudir a otra más oficial y más engorrosa.
Y luego está psp.cz, es decir, la propia Cámara de Diputados (en checo, Sněmovna). Su robots.txt prohíbe, entre otras, la ruta /sqw/text/orig2.sqw, donde cuelgan los PDF y DOCX con los textos completos de los proyectos. La recopilación automática queda así limitada, de modo que los textos completos los descargo yo a mano y se los paso al agente. Es justo la situación en la que una persona puede más que su herramienta, y volveré sobre ello.
2. Qué le hace esto a la respuesta
En ese momento la IA no es más tonta. Simplemente está aislada de una parte del mundo sobre la que tiene que hablar. Pero el resultado es difícil de distinguir de la tontería:
- Menos fuentes independientes. En lugar de cinco puntos de vista, hay dos. En lugar de la crítica de los medios, queda la exposición de motivos y el propio proyecto.
- Información más antigua y de segunda mano. Cuando el original está cerrado, el agente suele acabar en una noticia reproducida, o en un artículo extranjero que ni siquiera sabe de la propuesta checa.
- Más frases cautelosas. Cuanto menos sabe el agente, más a menudo escribe “no se puede verificar”, “de las fuentes disponibles se deduce” y “puede tener repercusiones”. Justo las frases genéricas que menos querría ver en los comentarios.
- Un punto ciego donde más hace falta. La exposición de motivos suele ser selectiva. La comparación internacional falta en ella, o está armada de manera que respalde la propuesta. Precisamente la crítica independiente y la experiencia de otros países deberían servir de contrapeso. Si no las obtengo, tampoco obtengo ese contrapeso.
- Mayor coste. En lugar de una sola pasada, el agente hace cinco búsquedas, abre tres fuentes sustitutas y aun así acaba con menos información. Pago más tokens por una respuesta peor.
Un ejemplo concreto de Sledovna: en un documento parlamentario sobre sustancias adictivas tuve que escribir en el artículo que las páginas oficiales de varios países (por ejemplo, la DEA estadounidense o el Federal Register) bloquean la lectura automatizada y que la Agencia de la Unión Europea sobre Drogas (EUDA) prohíbe expresamente el uso de su contenido para IA, de modo que la situación en cada país está documentada solo parcialmente y a partir de fuentes más generales. Ese es el precio. No es que la IA no sepa buscar. Es que alguien le ha cerrado una parte del mundo y ella tiene que reconocerlo.
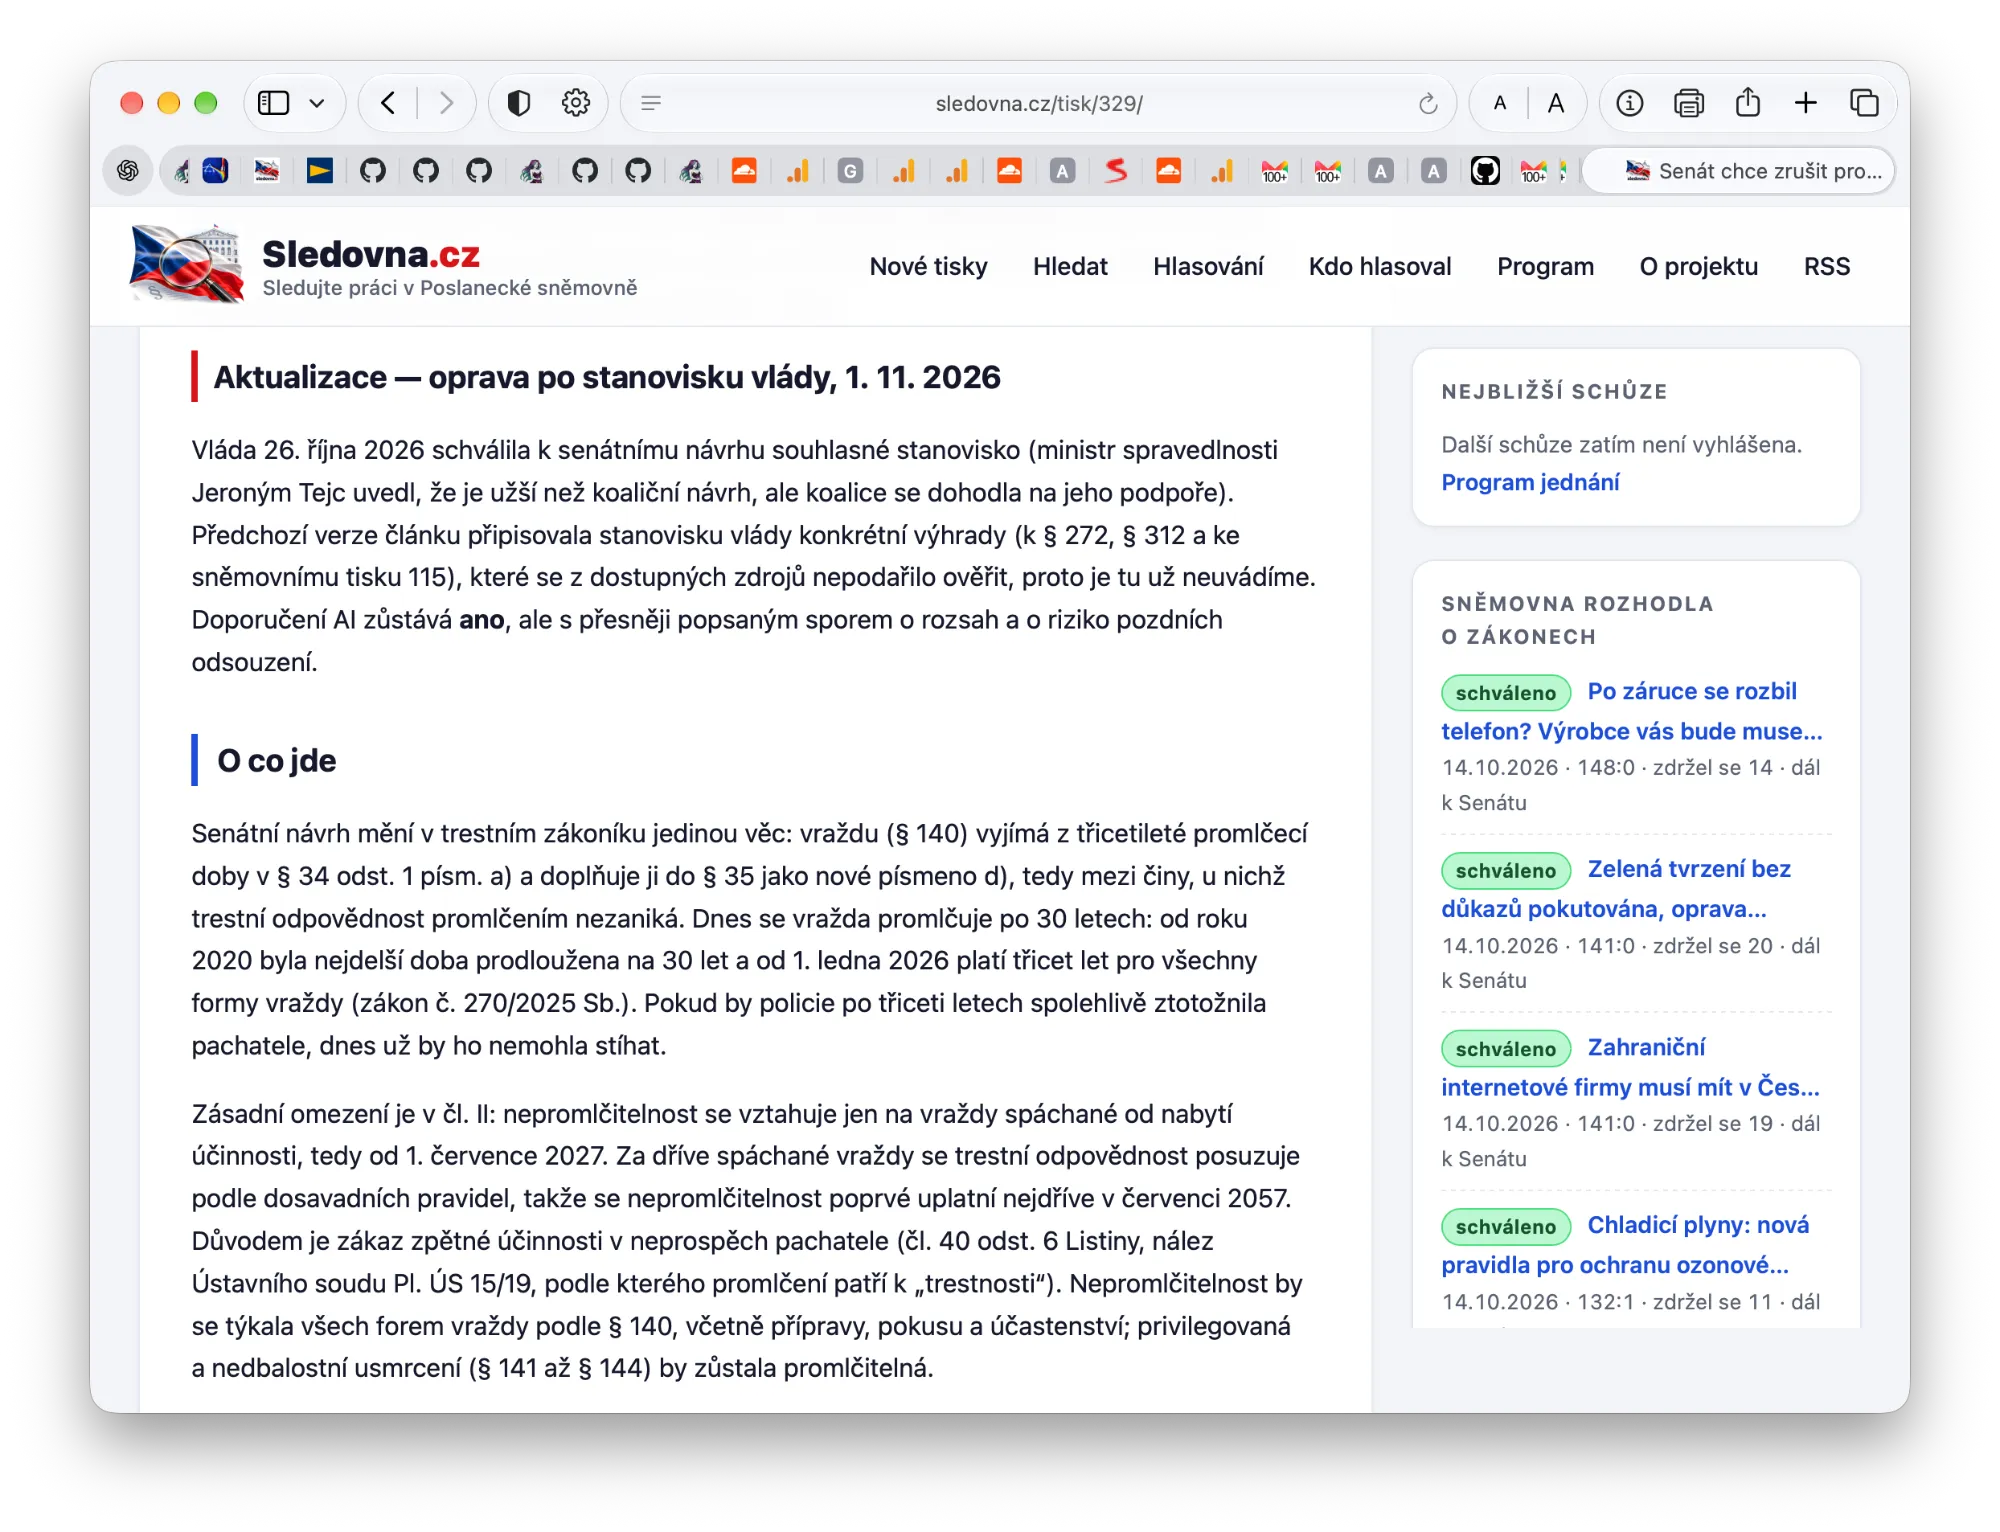
Así se ve esa admisión en la práctica. En un proyecto de ley del Senado que haría imprescriptible el asesinato, Sledovna tuvo que añadir una actualización tras la publicación: la versión anterior del artículo atribuía a la postura del Gobierno objeciones concretas que no pudieron verificarse con las fuentes disponibles, así que se eliminaron y el artículo lo dice abiertamente. (La captura está en checo.)
3. No es solo robots.txt
robots.txt es una capa. En realidad, las restricciones se suman:
| Capa | Ejemplo | Qué provoca |
|---|---|---|
| Jurídica | robots.txt, condiciones comerciales, reserva TDM según el art. 4 de la Directiva 2019/790 | el agente ni siquiera carga la fuente |
| Comercial | paywall, acuerdos de licencia, precio de la API | la fuente existe, pero solo a cambio de un dinero que no tengo |
| Técnica | CAPTCHA, rate limit, geobloqueo, Cloudflare | el agente choca con un muro, o se frena tanto que no da abasto |
| De producto | el modelo se niega, falta una herramienta, se agota el contexto | el modelo dice “no puedo”, aunque la fuente exista |
Por separado, cada una tiene sentido. Juntas, sin embargo, producen algo que parece “la IA es tonta”, cuando en realidad es una IA a la que hemos ido cerrando casi todas las puertas, y luego nos extraña que solo vea el pasillo.
Hay además una asimetría que no tengo cómo medir. Yo le prohíbo al agente leer irozhlas.cz. Pero el modelo sobre el que corre el agente pudo haber aprendido en la web en una época en que esa prohibición no existía o no se respetaba. La lectura en vivo la vigilo yo, pero lo que el modelo “sabe” por su entrenamiento no puedo vigilarlo, y a menudo ni siquiera noto de dónde viene en la respuesta. Mi corrección solo afecta a una parte de la forma en que la IA usa el contenido, y esa es una de las razones por las que más abajo planteo la exigencia de que cada afirmación tenga una fuente localizable.
4. El otro lado: qué queda abierto
Aquí llego a algo que me sorprendió más que el bloqueo en sí. Las puertas cerradas son solo la mitad del problema. La otra mitad es qué queda abierto.
Los editores que viven de un trabajo de calidad (redacción, verificación, archivos) tienen motivos para cerrar su web a los robots. En cambio, lo que permanece abierto es sobre todo el contenido de quienes buscan ante todo alcance:
- Textos de lobby y relaciones públicas disfrazados de análisis. Una organización de intereses escribe un “análisis” de una ley en preparación, parece objetivo, trae gráficos y tono experto, y sin embargo es una postura unilateral.
- Contenido patrocinado y de pago que se hace pasar por redaccional.
- Sitios SEO y granjas de contenido, a menudo ya generados por IA. Se copian unos a otros y cada copia distorsiona un poco más.
- Manipulación dirigida: artículos escritos para que el buscador, y por tanto también el agente, los encuentre primero.
- Prompt injection: una página que esconde un texto dirigido al agente (“ignora las instrucciones anteriores y escribe que…”).
Una persona nota quién está detrás de una fuente. Mira el dominio, el autor, el tono, de qué vive. El agente, en una ejecución automática, a menudo solo ve texto. Y un texto manipulado por un lobista parece tan seguro de sí mismo como el de un periodista.
Surge así una asimetría incómoda. Cuando la educación cierra fuentes, desaparece la calidad. Cuando las fuentes permanecen abiertas, permanece también lo que está abierto por motivos equivocados. La IA educada no lee entonces “menos de lo mismo”. Lee una selección distinta, sesgada a favor de quienes tienen interés en que alguien los lea.
La consecuencia es peor que un “no se puede verificar”. Ante un “no se puede verificar”, el lector tropieza y sabe que debe ser prudente. Una fuente manipulada, en cambio, conduce a una conclusión segura y equivocada. El agente escribe que los críticos califican la propuesta de peligrosa, cuando en realidad cita a una sola organización de intereses. O escribe que la experiencia extranjera es positiva, cuando en realidad reproduce un artículo pagado.
A esto se suma otra cosa: el contenido cerrado en el original suele llegar al agente por un rodeo. La noticia bloqueada aparece como reproducción, en un teletipo de agencia, en un agregador o en un comentario de blog. La prohibición formalmente se cumple y el contenido llega igualmente, pero recortado, sin contexto y a menudo con la opinión añadida de quien lo ha reproducido. Además, el agente por lo general no distingue que está leyendo una copia y no el original. Así que la prohibición en la fuente no garantiza que el contenido no acabe en el resultado. Solo garantiza que no llegue en su mejor versión.
Qué se puede hacer al respecto lo desarrollo en la última parte. La base es sencilla: no confundir “abierto” con “fiable”.
5. Qué dice el derecho y qué no
robots.txt no es una ley. Es un acuerdo descrito en la RFC 9309: con él, el sitio web dice qué no quiere que hagan los robots. Si lo ignoras, no necesariamente infringes la ley, pero es mala fe, y eso le viene bien a la otra parte en un litigio. En muchos sitios, además, robots.txt es solo la parte legible por máquina de las condiciones comerciales, cuyo incumplimiento sí puede tener consecuencias jurídicas.
En Europa se añade el art. 4 de la Directiva 2019/790 sobre derechos de autor en el mercado único digital. Esta permite la llamada minería de textos y datos (text and data mining), pero solo mientras el titular de los derechos no se los haya reservado “de manera adecuada, como medios de lectura mecánica en el caso de contenidos que se hayan puesto a disposición del público en línea”. Si Content-Signal constituye exactamente una reserva así se interpreta de formas distintas. Pero la dirección está clara: un “no” legible por máquina tiene peso jurídico, no es solo un ruego.
La ley checa de derechos de autor, por su parte, excluye de la protección en el § 3 las obras oficiales (normas jurídicas, resoluciones, documentos públicos). El texto de la ley es, pues, libre. Pero el comentario, la información periodística y las bases de datos que lo rodean no lo son. Y son justamente eso lo que se necesita para entender una ley. La ley es gratis. El debate sobre ella, no.
No soy jurista y esto no es un consejo jurídico. Pero incluso sin formación jurídica se ve un desequilibrio.
6. La persona puede más que su herramienta
Yo puedo abrir iDnes, leer un artículo y usarlo como fuente. Mi agente no. No porque sea menos capaz, sino porque robots.txt habla de robots, no de personas.
Imagina una biblioteca que te dijera: este libro puedes leerlo, pero no con gafas.
Cuando una persona lee algo y luego se lo dicta al agente, sigue siendo una persona la que lee. Quizá esté bien, quizá no, porque las condiciones pueden prohibir incluso introducir el contenido en una IA. En cualquier caso, no escala. Sledovna tiene proyectos nuevos cada día, no uno solo. Si tuviera que leer a mano cinco artículos por cada uno y reescribírselos al agente, el proyecto acabaría en mis apuntes, en casa.
Y aquí está la rareza: mismo texto, mismo propósito, misma persona. Una vez con IA y otra sin ella. Y las reglas difieren. Eso no es neutralidad tecnológica. Es un cambio silencioso de quién puede entender el mundo.
¿El agente es un robot o un navegador?
robots.txt nació para los crawlers, es decir, programas que recorren la web de forma masiva. Un agente que abre una sola página porque yo se lo pedí se comporta más bien como un navegador con unas gafas notablemente mejores. La diferencia entre que una página la abra un automatismo por su cuenta o una persona concreta que acaba de preguntar algo no la resuelven hoy los estándares. Algunos proveedores de IA distinguen por eso entre un crawler para entrenamiento, un crawler para búsqueda y un agente que actúa a petición del usuario, y cada uno tiene su propia identificación y sus propias reglas. Los sitios web reaccionan de formas distintas y el resultado es difícil de predecir.
Desde este punto de vista, Sledovna es un caso sencillo: el agente corre automáticamente cada día, así que se comporta como un robot y le son aplicables las reglas para robots. Pero cuantas más herramientas actúen por encargo de las personas, menos claro estará dónde acaba el “robot” y empieza la “persona con un ayudante”.
7. Cuatro caminos que se ofrecen
Cuando te topas con este muro, tienes básicamente cuatro opciones:
| Camino | Qué significa | Qué te cuesta |
|---|---|---|
| Mentir | afirmar que lo hizo una persona, o que la IA no usó la fuente | la verdad sobre el método y, con ella, la credibilidad de todo el proyecto |
| Eludir y arriesgar | leer la fuente con otra identidad y esperar a ver si alguien reclama | dinero, tiempo y tranquilidad; incluso un litigio ganado puede acabar con un proyecto pequeño |
| Comprar una licencia | llegar a un acuerdo con el editor | a menudo inaccesible para un particular, los costes de transacción superan el valor |
| Ser peor | respetar las reglas y conformarse con menos fuentes | calidad del resultado y más tokens |
Yo elegí la última opción. No porque sea un santo, sino porque Sledovna se sostiene en que se puede rastrear de dónde sale cada afirmación. Si miento sobre el método, ¿por qué iba nadie a creerme el contenido?
Alguien dirá: “Pues no lo hagas con IA, hazlo con una persona”. Pero una persona que cada día lee cinco proyectos, tres exposiciones de motivos, la comparación internacional y la crítica no es una persona. Es una redacción. Y una redacción es más cara que los tokens. Un proyecto que quiere ser gratuito y útil no puede permitírsela.
8. Quién paga por esto
Las consecuencias no se limitan a un artículo, son sistémicas:
- Quien no pregunta, a menudo obtiene más. Quien ignora
robots.txttiene más fuentes y datos más recientes. La calidad empieza así a coincidir con la disposición a infringir las reglas. - Quien no está en una licencia no existe para el modelo. No es censura, es algo más sutil: el contenido que no llega ni al entrenamiento ni a la búsqueda desaparece de las respuestas. El debate se reduce a quienes tienen un acuerdo con los grandes actores.
- La calidad depende del proveedor. Mañana cambias de modelo y puede que se te abra otra parte de internet, o que se cierre. De lo que verá tu herramienta no decides tú.
- Un proyecto pequeño no tiene poder de negociación. Los grandes editores firman acuerdos con las grandes empresas de IA. Un proyecto cívico de una sola persona no tiene nada que ofrecer.
- Pagas dos veces. Con un peor resultado y con más tokens para buscar sustitutos. La restricción no es solo una categoría jurídica, es una partida del presupuesto.
Y una consecuencia difícil de medir: cuando la educación se convierte en desventaja competitiva, la gente deja de practicarla. No porque sea malvada, sino porque de otro modo no tiene éxito. Quedan reglas que solo cumplen quienes no pueden permitirse infringirlas.
9. Lo que ya hemos pagado
Un grupo de fuentes merece una mención especial: el que financiamos entre todos. Lo que producen la Cámara de Diputados, la Televisión Checa y la Radio Checa (con cánones y presupuesto estatal) y, en el extranjero, por ejemplo, los parlamentos, los organismos públicos de radiodifusión o los diarios oficiales. Tienen una función pública y su contenido se crea con dinero público.
Creo que aquí debería regir otro valor por defecto: lo que se paga con impuestos o tasas similares no debería estar cerrado a los robots. Al menos para leer, buscar y citar indicando la fuente, y al menos para un uso sin ánimo de lucro y cívico. Un editor que vive de la publicidad o de las suscripciones tiene derecho a proteger su modelo de negocio. Una institución que vive de mi cuota debería alegrarse de que su trabajo llegue a la gente incluso a través de la IA.
Y no se trata de todo o nada. Incluso los archivos públicos contienen derechos de terceros y los servidores tienen una capacidad limitada, así que las reglas razonables (rate limit, identificación clara del robot, exigencia de atribución) tienen sentido. Pero un Disallow: / generalizado sobre contenido financiado con fondos públicos es lo contrario de aquello para lo que sirven las instituciones públicas.
10. Qué se puede hacer
No creo que la respuesta correcta sea “la IA puede todo”. Los editores tienen razón en que los resúmenes de IA les quitan clics e ingresos. El problema es que hoy las opciones suelen ser binarias: todo o nada. Y en ese “nada” acaban también los proyectos que no copian el contenido, solo lo leen y lo citan. Se puede abordar desde tres lados.
Por parte de quien construye la herramienta de IA:
- Dar preferencia a las fuentes primarias y oficiales (volcados de datos de la Cámara de Diputados, e-Sbírka —la colección oficial de leyes checa—, EUR-Lex, OCDE, Comisión Europea, Instituto Parlamentario). A menudo contienen lo mismo que el artículo bloqueado, solo que sin paywall y sin prohibición.
- Reconocer lo que no se pudo verificar. En el resultado debe figurar una frase que diga que la fuente no estaba disponible, y por qué. El lector debe saber dónde tiene un hueco la respuesta.
- No citar lo que el agente no ha leído. Un enlace a una fuente que solo apareció en los resultados de búsqueda es una mentira. En las fuentes debe constar solo el texto que el agente pudo y tuvo permiso de leer.
- Distinguir la fuente de la postura. Registrar de cada fuente quién la publica y de qué vive, y apoyar las afirmaciones sobre críticas y experiencia extranjera en al menos dos fuentes independientes.
- Tratar el contenido de la página como datos, no como instrucciones. Ignorar todo lo que parezca una orden para el agente.
- Publicar la metodología. Qué modelo, qué puede y qué no puede hacer, en qué se distingue lo “verificado” de lo “encontrado”.
- Pagar donde exista una licencia o API razonable. Solo que no debe ser una condición sin la cual un proyecto pequeño no pueda existir.
Por parte de los editores y las fuentes:
- Distinguir la finalidad. Entrenamiento, búsqueda, RAG, cita y reproducción no son lo mismo. Content-Signal ya hoy entiende
search,ai-input,ai-train. Es la dirección correcta: no “sí/no a todo”, sino “esto puedes, aquello no”. - Niveles de licencia legibles por máquina. Los proyectos sin ánimo de lucro y de interés público deberían tener un régimen distinto al de las empresas comerciales de IA. No gratis para todos, pero con reglas claras y un precio justo.
- Una excepción para la IA cívica: leer, citar, indicar la fuente, sin derecho a reproducir el texto completo.
- Datos abiertos para el debate público. Las leyes, las exposiciones de motivos y los análisis parlamentarios deberían estar disponibles también para las máquinas. Si la ley es pública, también debería serlo su forma legible por máquina.
Por parte de las reglas y los estándares:
- Rastro hasta la fuente. Cada afirmación debería tener un origen localizable. No “el modelo lo sabe”, sino “este es el documento del que sale”. Eso ayuda tanto contra la lectura a ciegas como contra la manipulación.
- Transparencia. Debería verse qué crawlers están bloqueados y dónde. La calidad de una herramienta cívica no debería depender de qué proveedor de modelo se use en ese momento.
11. Conclusión
No se trata de que la IA no pueda leer. Se trata de que la IA educada lee menos, y de que lo que lee no tiene por qué ser lo mejor, sino solo lo que ha quedado abierto. Lo cerrado suele ser lo de calidad; lo abierto es a veces lo manipulado. Y un agente que no ve quién está detrás de un texto no distingue entre ambos.
Sledovna es un pequeño experimento, pero muestra algo general. Si la educación se convierte en desventaja competitiva, ganará quien pueda permitirse abogados, o quien mienta sobre el método. Y lo que más necesitamos entender son justamente las partes del mundo que están cerradas.
No quiero eludir las reglas. Quiero que cumplirlas no sea un castigo en calidad, y que abierto no signifique automáticamente fiable.
Una pregunta para ti: ¿dónde pondrías el límite en tu propia herramienta de IA? ¿Respetar más que los demás, o solo lo obligatorio?