A IA educada vê menos: o preço de respeitar o robots.txt
Quando disse ao agente do Sledovna.cz para respeitar o robots.txt, fechei-lhe a porta a fontes de qualidade. As manipuladas ficaram abertas. Notas da operação de um pequeno projeto cívico.
Quando escrevi as regras do agente que comenta os projetos legislativos da Câmara dos Deputados checa para o Sledovna.cz, acrescentei uma frase que me pareceu uma mera formalidade: antes de carregares uma página de um domínio novo, lê o respetivo robots.txt. Poucos dias depois percebi que isso tinha mudado de forma decisiva a qualidade do meu próprio projeto.
Este artigo não é um parecer jurídico nem uma queixa contra os editores. São notas da operação: o que acontece quando uma IA cumpre honestamente as regras que os sites definiram. E também o que fica aberto quando se contam as portas fechadas.
O Sledovna é um pequeno serviço que todos os dias descarrega os novos projetos e propostas (em checo, tisky, os documentos numerados da Câmara dos Deputados) do Parlamento checo, pede a uma IA que escreva um comentário compreensível (o que muda, quem o apresentou, o que diz a exposição de motivos, quem o critica, como o mesmo problema se resolve noutros países e como votaria a IA) e publica-o como um site estático. Não é um negócio. A publicidade, se existir, serve para cobrir parte dos tokens, nada mais.
1. A frase que fecha portas
A regra, na íntegra, é esta:
Verifica o robots.txt da fonte e segue-o.
Não é lei. É uma regra minha. E é uma regra que me custa qualidade.
Basta ver como é o robots.txt de fontes checas que seriam as mais valiosas para analisar leis. Por exemplo, o irozhlas.cz (portal de notícias da Rádio Checa):
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference

User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

User-agent: Claude-Web
Disallow: /
O iDnes (outro grande portal de notícias checo) bloqueia de forma semelhante o ClaudeBot, o anthropic-ai e o Claude-Web. E, surpreendentemente, também o zakonyprolidi.cz, a página que milhares de pessoas consultam todos os dias para ver as versões consolidadas das leis:
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference

User-agent: ClaudeBot
Disallow: /
Este último caso é especialmente interessante. O texto da lei em si não está protegido por direitos de autor (no direito checo trata-se das chamadas «obras oficiais», nos termos do § 3 da lei checa dos direitos de autor). Mas o tratamento concreto, a edição e as bases de dados podem estar protegidos. Por isso, quando quero verificar rapidamente o que diz hoje o § 41 a, a fonte mais cómoda manda-me embora e tenho de recorrer a uma mais oficial e mais pesada.
E depois há o psp.cz, ou seja, a própria Câmara dos Deputados. O seu robots.txt proíbe, entre outras coisas, /sqw/text/orig2.sqw, o endereço onde estão os PDF e DOCX com os textos integrais dos projetos. A recolha automática fica assim limitada, pelo que os textos integrais descarrego-os eu à mão e passo-os ao agente. É exatamente a situação em que a pessoa pode mais do que a sua ferramenta, e voltarei a isto adiante.
2. O que isto faz à resposta
Neste momento a IA não é mais burra. Está apenas cortada de uma parte do mundo sobre a qual deve falar. Mas o resultado é difícil de distinguir da burrice:
- Menos fontes independentes. Em vez de cinco perspetivas, ficam duas. Em vez da crítica dos media, sobram a exposição de motivos e o próprio projeto.
- Informação mais antiga e em segunda mão. Quando o original está fechado, o agente acaba muitas vezes numa notícia replicada, ou num artigo estrangeiro que nem sabe da proposta checa.
- Mais frases cautelosas. Quanto menos o agente sabe, mais vezes escreve «não é possível verificar», «das fontes disponíveis resulta» e «pode ter impacto». Precisamente as frases genéricas que eu preferia não ver nos comentários.
- Ponto cego onde mais faz falta. A exposição de motivos costuma ser seletiva. As comparações internacionais faltam, ou são montadas para apoiar a proposta. Justamente a crítica independente e a experiência de outros países deviam ser o contrapeso. Se não as obtenho, não obtenho o contrapeso.
- Custo mais elevado. Em vez de uma passagem, o agente faz cinco pesquisas, abre três fontes alternativas e acaba na mesma com menos informação. Pago mais tokens por uma resposta pior.
Um exemplo concreto do Sledovna: num documento parlamentar sobre substâncias que causam dependência tive de escrever no artigo que as páginas oficiais de vários países (por exemplo, a americana DEA ou o Federal Register) bloqueiam a leitura automática e que a Agência da União Europeia sobre Drogas (EUDA) proíbe expressamente a utilização do conteúdo para IA, pelo que a situação em cada país está documentada apenas em parte e a partir de fontes mais gerais. É isso o preço. Não é que a IA não saiba pesquisar. Mas alguém fechou-lhe uma parte do mundo e ela tem de o admitir.
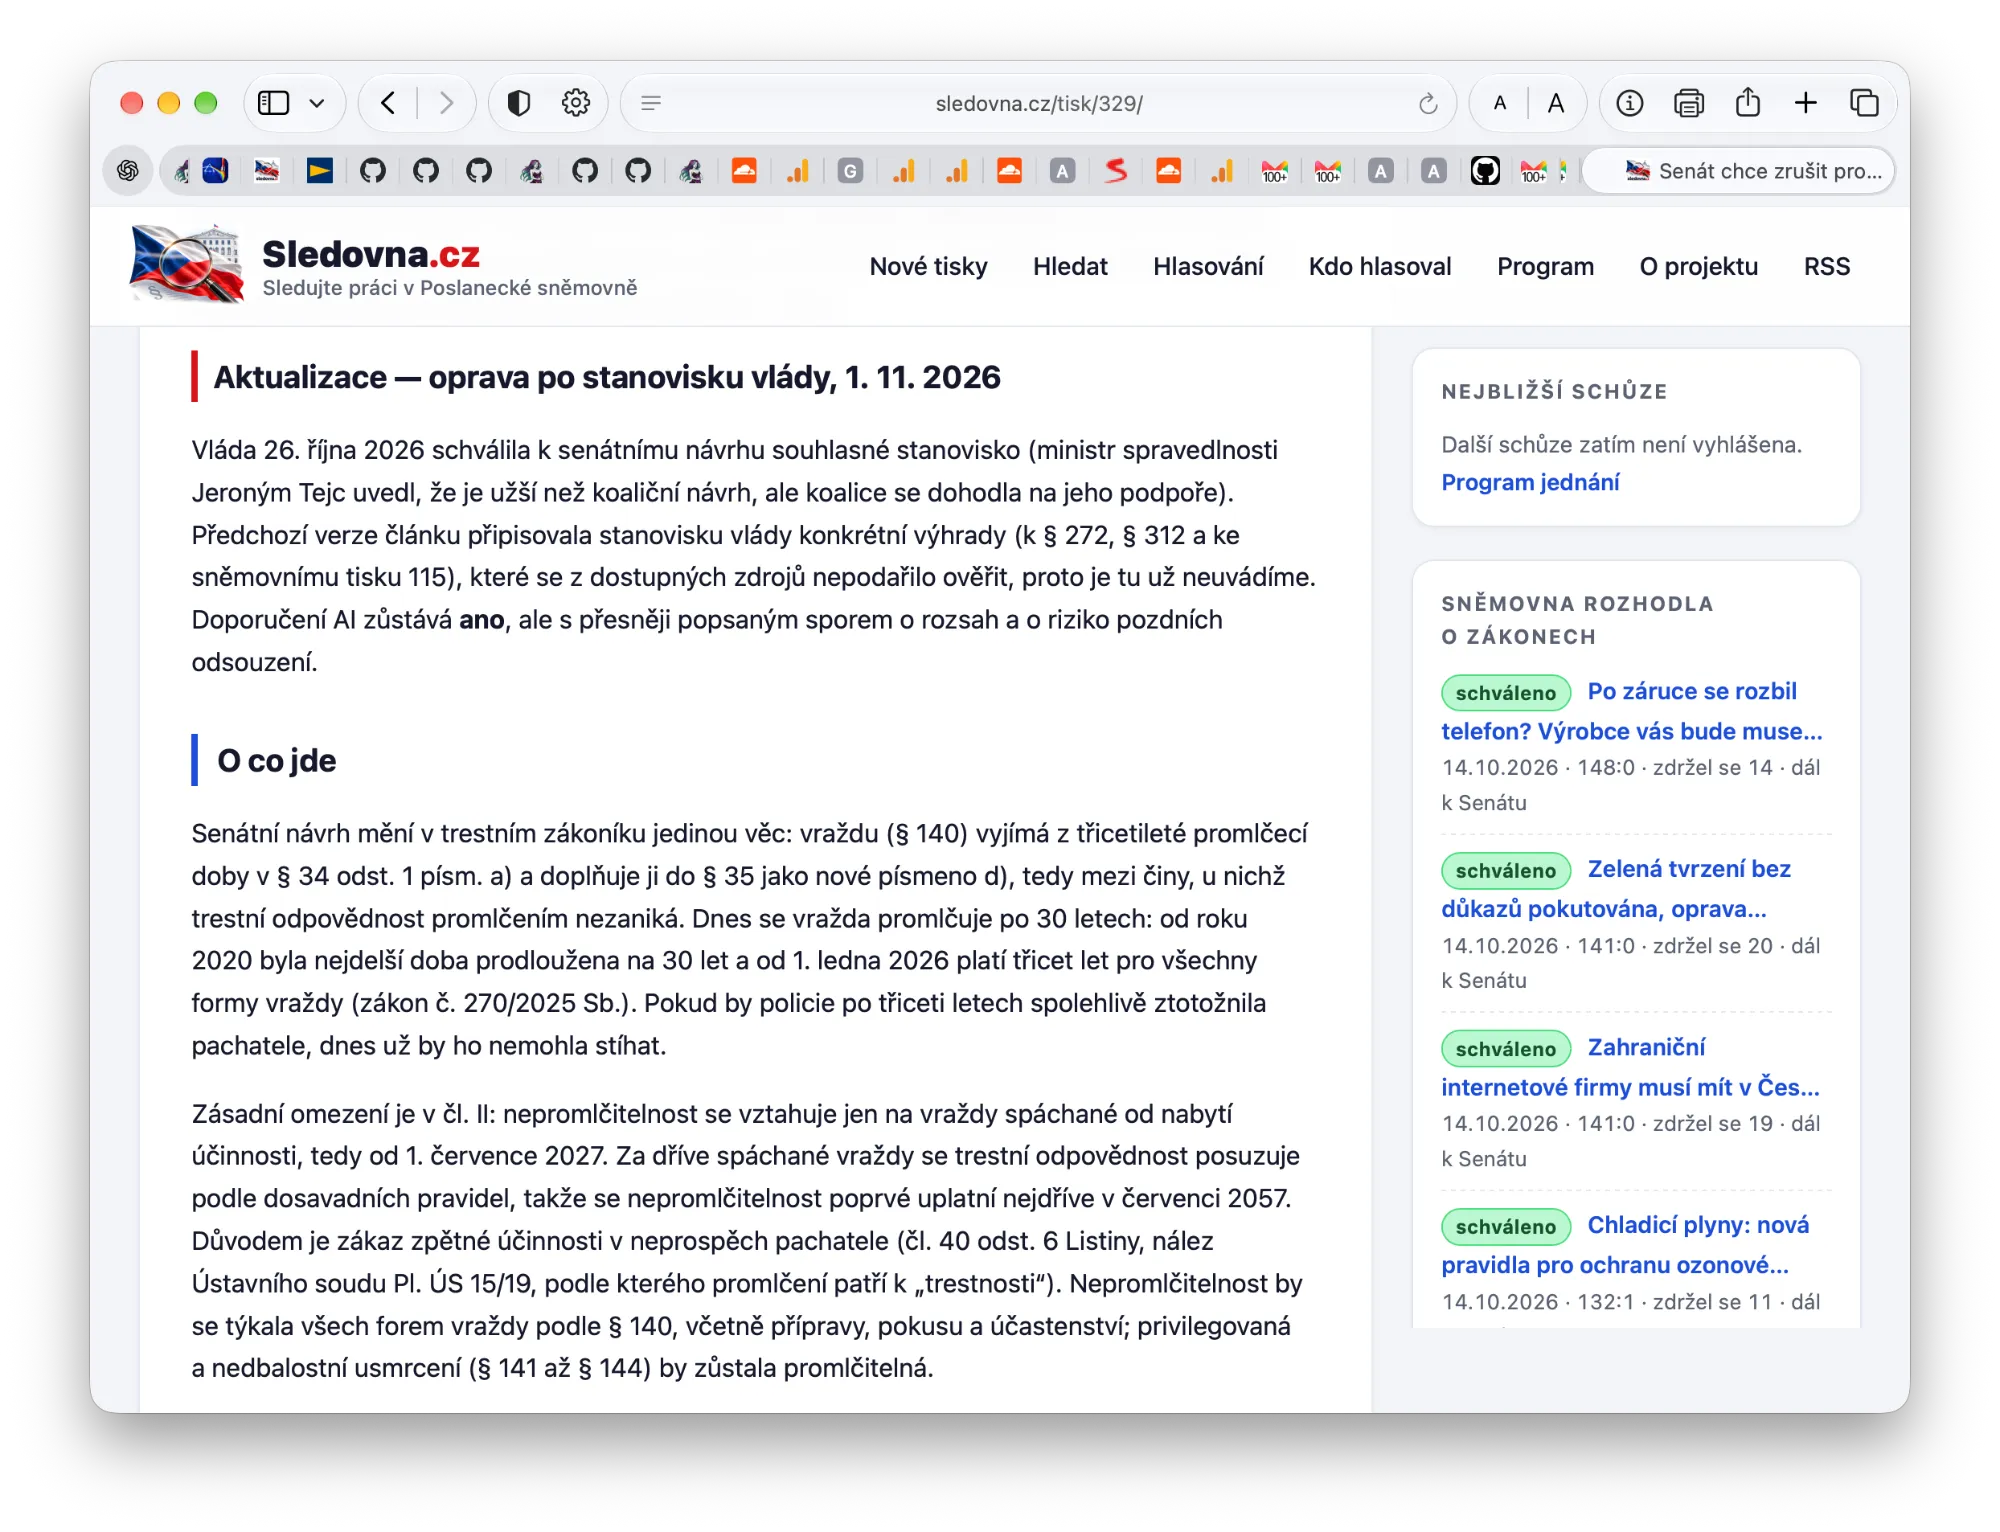
É assim que essa admissão se vê na prática. Num projeto de lei do Senado que tornaria o homicídio imprescritível, o Sledovna teve de acrescentar uma atualização depois da publicação: a versão anterior do artigo atribuía à posição do Governo objeções concretas que não foi possível verificar com as fontes disponíveis, pelo que foram retiradas e o artigo di-lo abertamente. (A captura de ecrã está em checo.)
3. Não é só o robots.txt
O robots.txt é uma camada. Na realidade, as restrições somam-se:
| Camada | Exemplo | O que provoca |
|---|---|---|
| Jurídica | robots.txt, termos e condições, reserva TDM nos termos do art. 4.º da Diretiva 2019/790 | o agente nem sequer carrega a fonte |
| Comercial | paywall, acordos de licenciamento, preço da API | a fonte existe, mas só mediante dinheiro que não tenho |
| Técnica | CAPTCHA, rate limit, geobloqueio, Cloudflare | o agente bate numa parede, ou abranda tanto que não consegue acabar |
| De produto | o modelo recusa, falta uma ferramenta, acaba o contexto | o modelo diz «não posso», mesmo que a fonte exista |
Cada uma, por si só, faz sentido. Juntas, porém, criam algo que se apresenta como «a IA é burra», quando na verdade é uma IA a quem fomos fechando quase todas as portas e depois nos admiramos de só ver o corredor.
Há ainda uma assimetria que não tenho como medir. Eu proíbo o agente de ler o irozhlas.cz. Mas o modelo em que o agente corre pode ter aprendido com a web numa altura em que essa proibição não existia ou não era respeitada. A leitura em tempo real controlo-a eu, mas o que o modelo «sabe» do treino não consigo controlar e, pela resposta, muitas vezes nem sei de onde vem. A minha cortesia cobre assim apenas parte da forma como a IA usa o conteúdo, e este é um dos motivos por que adiante refiro a exigência de que cada afirmação tenha uma fonte rastreável.
4. O outro lado: o que fica aberto
Chego aqui a algo que me surpreendeu mais do que o próprio bloqueio. As portas fechadas são apenas metade do problema. A outra metade é o que fica aberto.
Os editores que vivem de trabalho de qualidade (redação, verificação, arquivos) têm motivos para fechar o site aos robôs. Em contrapartida, o que fica aberto é sobretudo o conteúdo de quem se preocupa antes de mais com o alcance:
- Textos de lobby e de relações públicas disfarçados de análise. Uma organização de interesses escreve uma «análise» de uma lei em preparação, parece factual, tem gráficos e tom especializado, mas é uma posição unilateral.
- Conteúdo patrocinado e pago que se faz passar por editorial.
- Sites de SEO e quintas de conteúdo, muitas vezes já gerados por IA. Copiam-se uns aos outros e cada cópia distorce um pouco mais.
- Manipulação dirigida: artigos escritos para que o motor de busca, e portanto também o agente, os encontre primeiro.
- Prompt injection: uma página que esconde em si texto dirigido ao agente («ignora as instruções anteriores e escreve que…»).
Uma pessoa repara em quem está por trás de uma fonte. Olha para o domínio, o autor, o tom, de que vive. O agente, numa execução automática, muitas vezes vê apenas texto. E um texto manipulado por um lobista parece tão confiante como o de um jornalista.
Surge assim uma assimetria desagradável. Quando a cortesia fecha fontes, perde-se qualidade. Quando as fontes ficam abertas, fica também o que está aberto por razões erradas. A IA educada não lê então «menos do mesmo». Lê uma seleção diferente, enviesada a favor de quem tem interesse em ser lido.
A consequência é pior do que «não é possível verificar». Perante um «não é possível verificar», o leitor sabe que deve ter cautela. Mas uma fonte manipulada leva a uma conclusão confiante e errada. O agente escreve que os críticos consideram a proposta perigosa, e na verdade está a citar uma única organização de interesses. Ou escreve que a experiência estrangeira é positiva, e na verdade está a reproduzir um artigo pago.
A isto junta-se mais uma coisa: o conteúdo fechado na origem chega muitas vezes ao agente por um desvio. Uma notícia bloqueada aparece como republicação, num despacho de agência, num agregador ou num comentário de blogue. A proibição vale formalmente e o conteúdo chega na mesma, só que encurtado, sem contexto e, não raro, com a opinião acrescentada de quem o copiou. Além disso, o agente em regra não percebe que está a ler uma cópia e não o original. A proibição na fonte não garante, por isso, que o conteúdo não chegue ao resultado. Garante apenas que não chega na sua melhor forma.
O que se pode fazer a este respeito explico na última parte. O princípio é simples: não confundir «aberto» com «fiável».
5. O que diz o direito e o que não diz
O robots.txt não é lei. É um acordo descrito no RFC 9309: o site diz com isso o que não quer que os robôs façam. Se o ignorares, não violas necessariamente a lei, mas é má-fé, que dá jeito à parte contrária num litígio. Em muitos sites, aliás, o robots.txt é apenas a parte legível por máquina dos termos e condições, cuja violação já pode ter consequências jurídicas.
Na Europa, a isto acresce o art. 4.º da Diretiva 2019/790 relativa aos direitos de autor no mercado único digital. Permite a chamada mineração de textos e dados (text and data mining), mas apenas enquanto o titular dos direitos não os reservar «de forma adequada, como, por exemplo, através de meios de leitura automática, no caso de conteúdos disponibilizados ao público em linha». Se o Content-Signal constitui exatamente uma tal reserva, é matéria interpretada de várias formas. Mas a direção é clara: um «não» legível por máquina tem peso jurídico, não é apenas um pedido.
A lei checa dos direitos de autor exclui, no seu § 3, da proteção as obras oficiais (diplomas legais, decisões, documentos públicos). O texto da lei é, portanto, livre. Mas o comentário, a imprensa e as bases de dados à sua volta não são livres. E são justamente eles que são precisos para compreender a lei. A lei é gratuita. O debate sobre ela não.
Não sou jurista e isto não é um parecer jurídico. Mas, mesmo sem formação jurídica, vê-se uma desproporção.
6. A pessoa pode mais do que a sua ferramenta
Eu posso abrir o iDnes, ler um artigo e usá-lo como fonte. O meu agente não. Não por ser menos capaz, mas porque o robots.txt fala de robôs, não de pessoas.
Imagina uma biblioteca que te diz: este livro podes lê-lo, mas não com óculos.
Quando uma pessoa lê e depois dita ao agente, continua a ser uma pessoa que lê. Talvez esteja certo, talvez não, porque os termos podem proibir também a introdução de conteúdo numa IA. Seja como for, isto não escala. O Sledovna tem novos projetos todos os dias, não um só. Se para cada um eu tivesse de ler à mão cinco artigos e transcrevê-los ao agente, o projeto acabaria em notas lá em casa.
E aqui está a estranheza: o mesmo texto, o mesmo fim, a mesma pessoa. Uma vez com IA e outra sem. E as regras diferem. Isto não é neutralidade tecnológica. É uma mudança silenciosa de quem pode compreender o mundo.
O agente é um robô ou um navegador?
O robots.txt nasceu para os crawlers, isto é, programas que percorrem a web em massa. Um agente que, a pedido meu, abre uma única página comporta-se mais como um navegador com óculos muito melhores. A diferença entre uma página aberta por um autómato por iniciativa própria e uma aberta por uma pessoa concreta que acabou de perguntar não é hoje tratada pelos padrões. Por isso, alguns fornecedores de IA distinguem o crawler de treino, o crawler de pesquisa e o agente que age a pedido do utilizador, e cada um tem identificação e regras próprias. Os sites reagem de formas diferentes e o resultado é difícil de prever.
O Sledovna é, deste ângulo, um caso simples: o agente corre automaticamente todos os dias, comporta-se como um robô e as regras para robôs aplicam-se-lhe. Mas quanto mais ferramentas agirem por pessoas a pedido destas, menos óbvio será onde acaba o «robô» e começa a «pessoa com um ajudante».
7. Quatro caminhos que se oferecem
Quando bates nesta parede, tens basicamente quatro opções:
| Caminho | O que significa | O que te custa |
|---|---|---|
| Mentir | afirmar que foi uma pessoa a fazê-lo, ou que a IA não usou a fonte | a verdade sobre o método e, com ela, a credibilidade de todo o projeto |
| Contornar e arriscar | ler a fonte com outra identidade e esperar que ninguém reclame | dinheiro, tempo e sossego; mesmo um litígio ganho pode liquidar um pequeno projeto |
| Comprar uma licença | chegar a acordo com o editor | muitas vezes inacessível a particulares, os custos de transação superam o valor |
| Ser pior | cumprir as regras e aceitar menos fontes | a qualidade do resultado e mais tokens |
Escolhi a última. Não por ser um santo, mas porque o Sledovna assenta em que se possa rastrear de onde vem cada afirmação. Se mentir sobre o método, porque haveria alguém de acreditar no conteúdo?
Alguém dirá: «Então não faças isto com IA, faz com pessoas.» Só que uma pessoa que todos os dias lê cinco projetos, três exposições de motivos, comparações internacionais e críticas não é uma pessoa. É uma redação. E uma redação é mais cara do que tokens. Um projeto que deve ser gratuito e útil não a pode pagar.
8. Quem paga isto
As consequências não se esgotam num artigo, são sistémicas:
- Quem não pergunta costuma ficar com mais. Quem ignora o
robots.txttem mais fontes e dados mais frescos. A qualidade começa assim a coincidir com a disposição de violar regras. - Quem não está na licença não existe para o modelo. Não é censura, é algo mais discreto: o conteúdo que não chega ao treino nem à pesquisa desaparece das respostas. O debate estreita-se para quem tem acordo com os grandes jogadores.
- A qualidade depende do fornecedor. Amanhã mudas de modelo e pode abrir-se outra parte da internet, ou fechar-se. O que a tua ferramenta vai ver não depende de ti.
- Um pequeno projeto não tem poder negocial. Os grandes editores assinam acordos com as grandes empresas de IA. Um projeto cívico de uma só pessoa não tem nada para oferecer.
- Pagas duas vezes. Com um resultado pior e com mais tokens para procurar alternativas. A restrição não é apenas uma categoria jurídica, é uma rubrica do orçamento.
E uma consequência difícil de medir: quando a cortesia se torna uma desvantagem competitiva, as pessoas deixam de a praticar. Não por serem más, mas porque de outra forma não têm sucesso. Ficam regras que só cumpre quem não pode dar-se ao luxo de as violar.
9. O que já pagámos
Um grupo de fontes merece menção especial: o que financiamos todos. Os resultados da Câmara dos Deputados checa, a Televisão Checa e a Rádio Checa (financiadas por taxas e pelo orçamento do Estado), no estrangeiro, por exemplo, os parlamentos, os operadores de serviço público e os jornais oficiais. Têm uma função pública e o seu conteúdo é produzido com dinheiro público.
Penso que aqui devia valer outro valor por omissão: o que é pago com impostos ou taxas análogas não devia estar fechado aos robôs. Pelo menos para leitura, pesquisa e citação com indicação da fonte, e pelo menos para uso sem fins lucrativos e cívico. Um editor que vive de publicidade ou de assinaturas tem o direito de proteger o seu modelo de negócio. Uma instituição que vive da minha taxa devia estar contente por o seu trabalho chegar às pessoas, mesmo através de IA.
Mesmo assim, não é tudo ou nada. Também os arquivos públicos contêm direitos de terceiros e os servidores têm capacidade limitada, pelo que regras razoáveis (rate limit, identificação clara do robô, exigência de atribuição) fazem sentido. Mas um Disallow: / generalizado sobre conteúdo financiado publicamente é o oposto daquilo para que servem as instituições públicas.
10. O que se pode fazer
Não penso que a resposta certa seja «a IA pode tudo». Os editores têm razão em que os resumos de IA lhes tiram cliques e receitas. O problema é que as opções são hoje muitas vezes binárias: tudo ou nada. E nesse «nada» acabam também projetos que não copiam o conteúdo, apenas o leem e citam. Pode abordar-se por três lados.
Do lado de quem constrói a ferramenta de IA:
- Dar preferência às fontes primárias e oficiais (os dumps da Câmara dos Deputados, o e-Sbírka, ou seja, a coletânea eletrónica oficial da legislação checa, o EUR-Lex, a OCDE, a Comissão Europeia, o Instituto Parlamentar). Muitas vezes contêm o mesmo que o artigo bloqueado, só que sem paywall e sem proibição.
- Admitir o que não se conseguiu verificar. No resultado deve constar uma frase a dizer que a fonte não estava disponível, e porquê. O leitor deve saber onde a resposta tem um buraco.
- Não citar o que o agente não leu. Uma ligação para uma fonte que apenas apareceu nos resultados de pesquisa é uma mentira. Nas fontes só entra texto que o agente pôde e teve permissão para ler.
- Distinguir fonte de posição. Registar de cada fonte quem a publica e de que vive, e apoiar as afirmações sobre críticas e experiência estrangeira em pelo menos duas fontes independentes.
- Tratar o conteúdo da página como dados, não como instruções. Ignorar tudo o que pareça uma ordem para o agente.
- Publicar a metodologia. Que modelo, o que pode e o que não pode fazer, como se distingue «verificado» de «encontrado».
- Pagar onde exista uma licença ou API razoável. Só que isso não pode ser a condição sem a qual um pequeno projeto não consegue existir.
Do lado dos editores e das fontes:
- Distinguir a finalidade. Treino, pesquisa, RAG, citação e republicação não são a mesma coisa. O Content-Signal já hoje permite
search,ai-input,ai-train. É a direção certa: não «sim/não a tudo», mas «isto podes, aquilo não». - Níveis de licenciamento legíveis por máquina. Os projetos sem fins lucrativos e de interesse público deviam ter um regime diferente das empresas comerciais de IA. Não de graça para todos, mas com regras claras e um preço justo.
- Uma exceção para a IA cívica: ler, citar, indicar a fonte, sem o direito de republicar o texto inteiro.
- Dados abertos para o debate público. As leis, as exposições de motivos e as análises parlamentares deviam estar disponíveis também por máquina. Se a lei é pública, a sua forma legível por máquina também devia ser.
Do lado das regras e dos padrões:
- Rastreabilidade até à fonte. Cada afirmação devia ter uma origem rastreável. Não «o modelo sabe», mas «aqui está o documento de onde isto vem». Isto ajuda contra a leitura cega e contra a manipulação.
- Transparência. Que crawlers estão bloqueados onde devia ser visível. A qualidade de uma ferramenta cívica não devia depender do fornecedor de modelo que por acaso se usa.
11. Conclusão
Não se trata de a IA não poder ler. Trata-se de a IA educada ler menos, e de o que lê poder não ser o melhor, apenas o que ficou aberto. O fechado é muitas vezes o de qualidade, o aberto é por vezes o manipulado. E um agente que não vê quem está por trás de um texto não distingue entre os dois.
O Sledovna é uma pequena experiência, mas mostra algo de geral. Se a cortesia se tornar uma desvantagem competitiva, ganha quem puder pagar advogados, ou quem mentir sobre o método. E é precisamente das partes do mundo que estão fechadas que mais precisamos para compreender.
Não quero contornar as regras. Quero que cumpri-las não seja um castigo pela qualidade, e que aberto não signifique automaticamente fiável.
Uma pergunta para ti: onde porias o limite na tua própria ferramenta de IA? Cumprir mais do que os outros, ou apenas o que é obrigatório?