Anständige KI sieht weniger: der Preis fürs Befolgen von robots.txt
Als ich dem Agenten für Sledovna.cz sagte, er solle robots.txt respektieren, habe ich ihm die Tür zu hochwertigen Quellen geschlossen. Offen blieben auch die manipulierten. Notizen aus dem Betrieb eines kleinen Bürgerprojekts.
Als ich für Sledovna.cz die Regeln für einen Agenten schrieb, der Parlamentsdrucksachen kommentiert, habe ich einen Satz ergänzt, der mir wie eine Formalität vorkam: Bevor du eine Seite einer neuen Domain lädst, lies ihre robots.txt. Ein paar Tage später stellte ich fest, dass ich damit die Qualität meines eigenen Projekts grundlegend beeinflusst hatte.
Dieser Artikel ist weder Rechtsberatung noch eine Beschwerde über Verlage. Es sind Notizen aus dem Betrieb: was passiert, wenn eine KI die Regeln gewissenhaft befolgt, die sich Websites gegeben haben. Und auch, was offen bleibt, wenn man die geschlossenen Türen abzieht.
Sledovna ist ein kleiner Dienst, der jeden Tag die neuen Drucksachen („tisky“) aus der Poslanecká sněmovna (dem Abgeordnetenhaus des tschechischen Parlaments) herunterlädt, von einer KI einen verständlichen Kommentar schreiben lässt (was sich ändert, wer es eingebracht hat, was die Begründung sagt, wer es kritisiert, wie dasselbe Problem anderswo gelöst wird und wie die KI abstimmen würde) und ihn als statische Website veröffentlicht. Es ist kein Geschäft. Werbung soll allenfalls einen Teil der Tokens decken, mehr nicht.
1. Der Satz, der Türen schließt
Die Regel lautet vollständig so:
Prüfe bei der Quelle die robots.txt und halte dich daran.
Das ist kein Gesetz. Es ist meine Regel. Und es ist eine Regel, die mich Qualität kostet.
Man muss sich nur ansehen, wie die robots.txt bei tschechischen Quellen aussieht, die für die Analyse von Gesetzen am wertvollsten wären. Zum Beispiel irozhlas.cz (das Nachrichtenportal des Tschechischen Rundfunks):
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference

User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

User-agent: Claude-Web
Disallow: /
Ähnlich sperrt iDnes (eines der größten tschechischen Nachrichtenportale) ClaudeBot, anthropic-ai und Claude-Web. Und überraschenderweise auch zakonyprolidi.cz, also die Seite, die täglich Tausende Menschen wegen der konsolidierten Gesetzesfassungen aufrufen:
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference

User-agent: ClaudeBot
Disallow: /
Das Letzte ist besonders interessant. Der Gesetzestext selbst ist urheberrechtlich nicht geschützt (im tschechischen Recht handelt es sich um ein sogenanntes „amtliches Werk“ nach § 3 des tschechischen Urheberrechtsgesetzes). Aber die konkrete Aufbereitung, Redaktion und die Datenbank können durchaus geschützt sein. Wenn ich also schnell prüfen will, wie § 41 a heute lautet, schickt mich die bequemste Quelle weg, und ich muss zu einer offizielleren und sperrigeren greifen.
Und dann ist da psp.cz, also das Abgeordnetenhaus selbst. Seine robots.txt verbietet unter anderem /sqw/text/orig2.sqw, die Adresse, unter der die PDF- und DOCX-Volltexte der Drucksachen liegen. Das automatische Einsammeln ist damit eingeschränkt, deshalb lade ich die Volltexte von Hand herunter und gebe sie dem Agenten. Das ist genau die Situation, in der ein Mensch mehr darf als sein Werkzeug, und darauf komme ich noch zurück.
2. Was das mit der Antwort macht
Die KI ist in diesem Moment nicht dümmer. Sie ist nur von einem Teil der Welt abgeschnitten, über den sie sprechen soll. Das Ergebnis lässt sich von Dummheit aber kaum unterscheiden:
- Weniger unabhängige Quellen. Statt fünf Perspektiven gibt es zwei. Statt Kritik aus den Medien bleiben die Gesetzesbegründung und die Drucksache selbst.
- Ältere und sekundäre Informationen. Ist das Original gesperrt, landet der Agent oft bei einer übernommenen Meldung oder bei einem ausländischen Artikel, der von der tschechischen Vorlage gar nichts weiß.
- Mehr vorsichtige Sätze. Je weniger der Agent weiß, desto öfter schreibt er „nicht überprüfbar“, „aus den verfügbaren Quellen ergibt sich“ und „kann Auswirkungen haben“. Genau jene allgemeinen Floskeln, die ich in den Kommentaren am liebsten nicht hätte.
- Ein blinder Fleck dort, wo man am meisten braucht. Die Gesetzesbegründung ist oft selektiv. Der Auslandsvergleich fehlt darin, oder er ist so zusammengestellt, dass er den Entwurf stützt. Gerade unabhängige Kritik und Erfahrungen aus anderen Ländern sollen das Gegengewicht sein. Bekomme ich sie nicht, bekomme ich auch das Gegengewicht nicht.
- Höhere Kosten. Statt eines Durchlaufs macht der Agent fünf Suchen, öffnet drei Ersatzquellen und endet trotzdem mit weniger Informationen. Ich zahle mehr Tokens für eine schlechtere Antwort.
Ein konkretes Beispiel aus Sledovna: Bei einer Drucksache zu Suchtmitteln musste ich in den Artikel schreiben, dass die amtlichen Seiten mehrerer Staaten (etwa die US-amerikanische DEA oder das Federal Register) automatisiertes Lesen blockieren und die Europäische Drogenagentur (EUDA) die Nutzung ihrer Inhalte für KI ausdrücklich untersagt, sodass die Lage in den einzelnen Ländern nur teilweise und aus allgemeineren Quellen belegt ist. Genau das ist der Preis. Nicht, dass die KI nicht suchen könnte. Aber jemand hat ihr einen Teil der Welt verschlossen, und sie muss es zugeben.
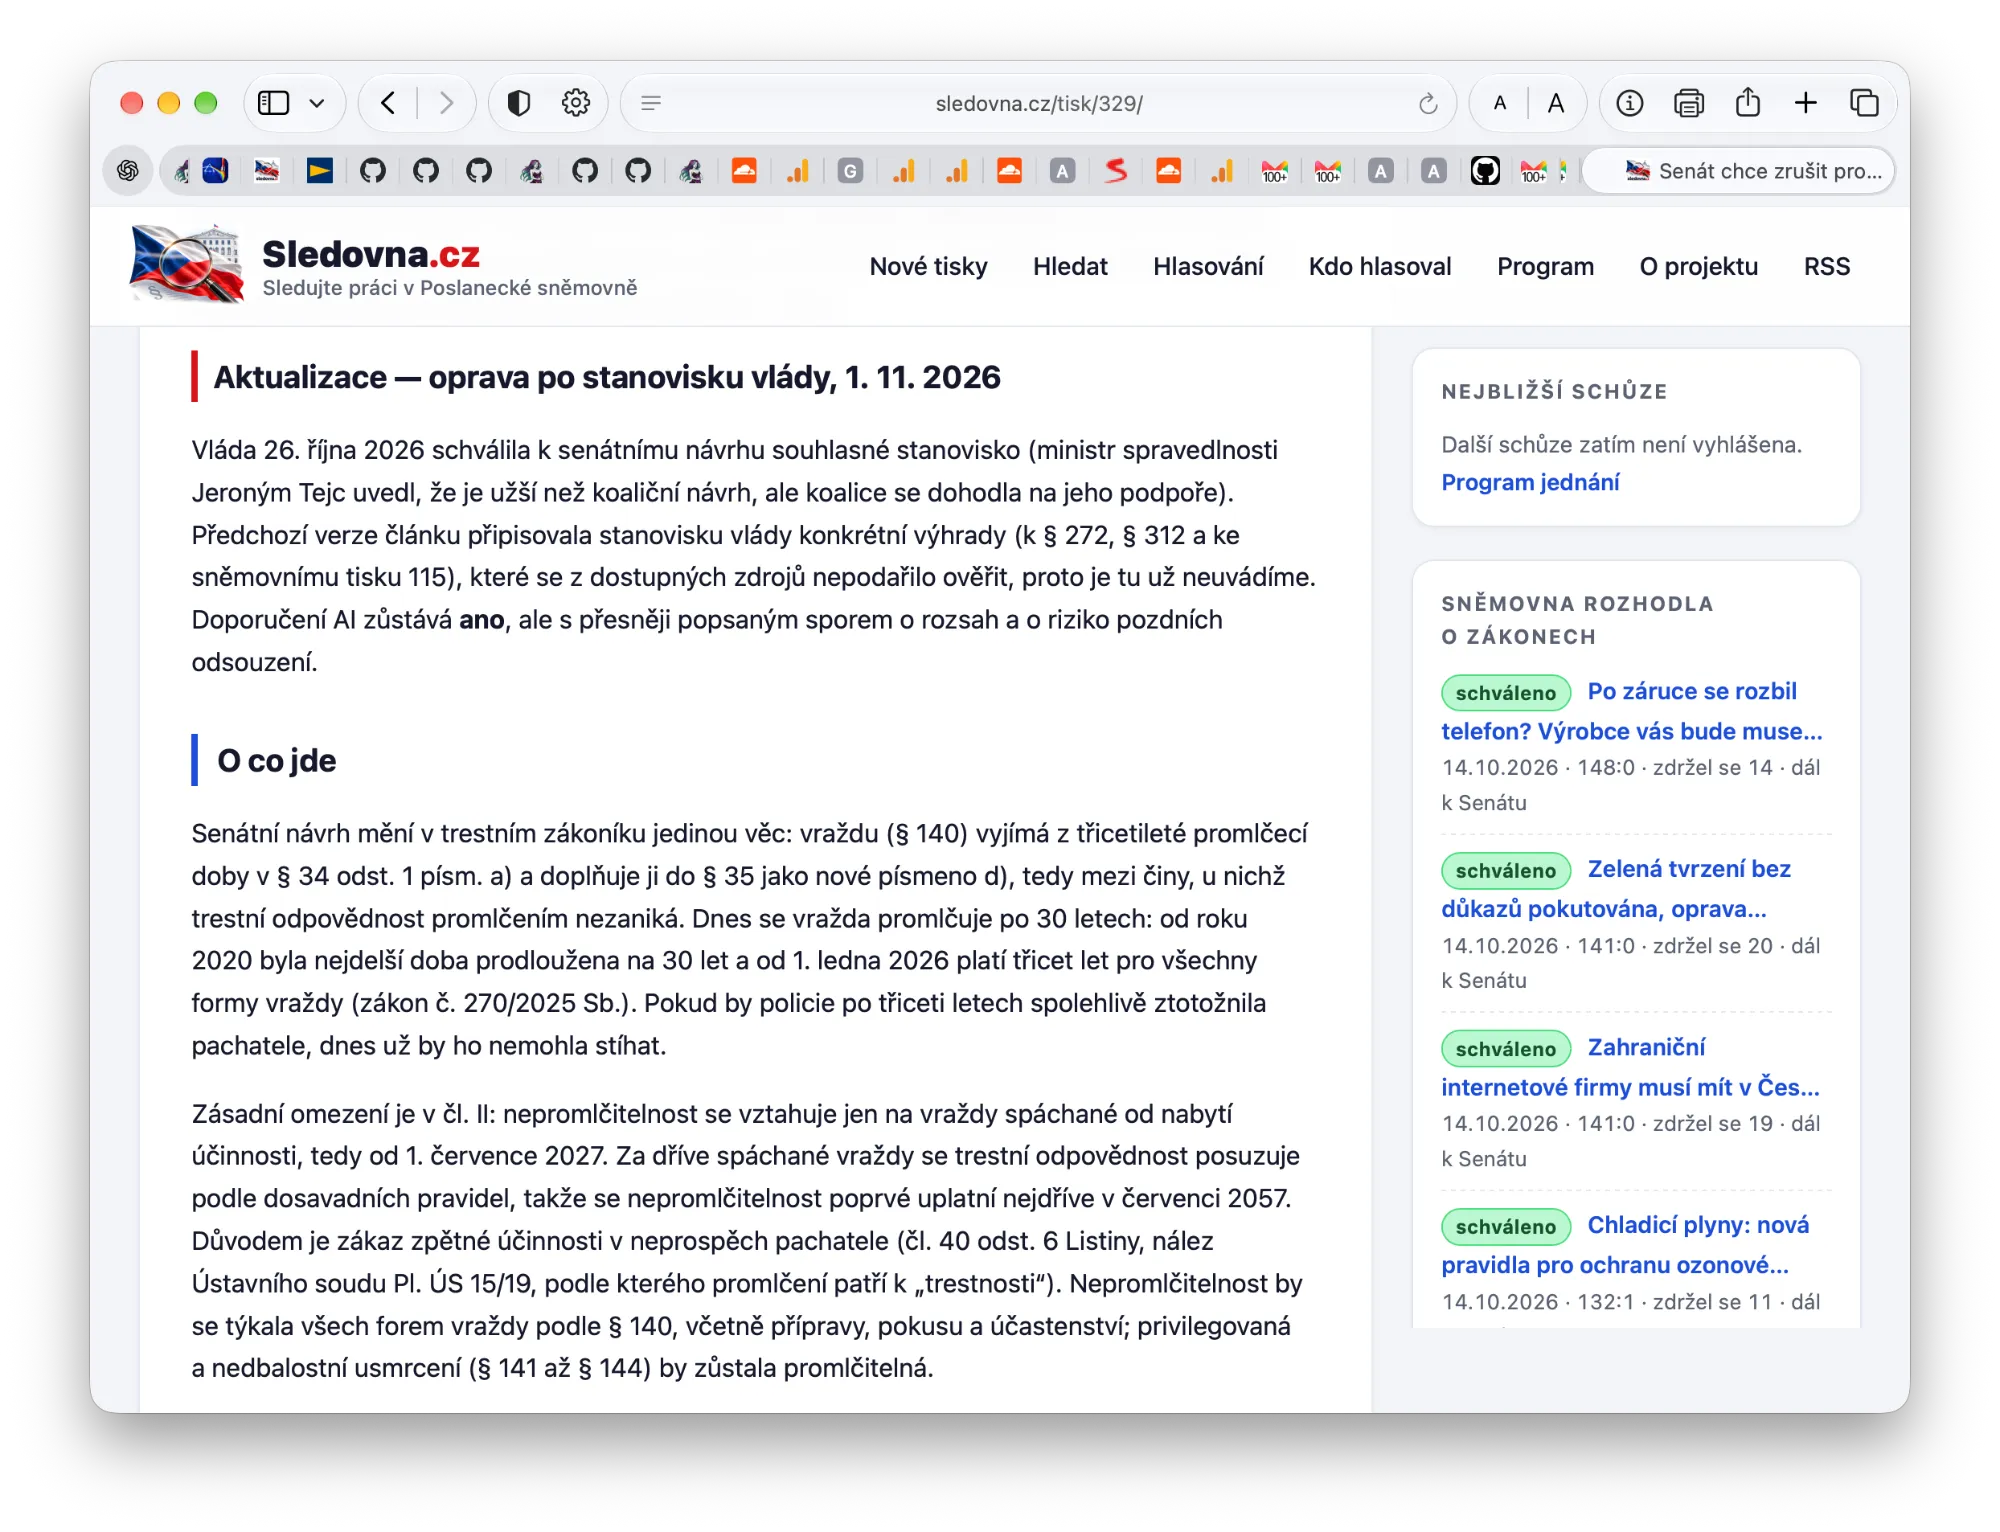
So sieht ein solches Eingeständnis in der Praxis aus. Bei einem Gesetzentwurf des Senats, der Mord unverjährbar machen würde, musste Sledovna nach der Veröffentlichung ein Update ergänzen: Die frühere Fassung des Artikels hatte der Stellungnahme der Regierung konkrete Einwände zugeschrieben, die sich anhand der verfügbaren Quellen nicht überprüfen ließen. Sie wurden deshalb entfernt, und der Artikel sagt das offen. (Der Screenshot ist auf Tschechisch.)
3. Es geht nicht nur um robots.txt
robots.txt ist eine Schicht. In Wirklichkeit addieren sich die Einschränkungen:
| Schicht | Beispiel | Was es bewirkt |
|---|---|---|
| Rechtlich | robots.txt, Nutzungsbedingungen, TDM-Vorbehalt nach Art. 4 der Richtlinie 2019/790 | der Agent lädt die Quelle gar nicht erst |
| Geschäftlich | Paywall, Lizenzvereinbarungen, API-Preis | die Quelle existiert, aber nur gegen Geld, das ich nicht habe |
| Technisch | CAPTCHA, Rate Limit, Geoblocking, Cloudflare | der Agent stößt an eine Wand oder wird so langsam, dass er nicht mehr fertig wird |
| Produktseitig | das Modell lehnt ab, ein Werkzeug fehlt, der Kontext geht aus | das Modell sagt „kann ich nicht“, obwohl die Quelle existiert |
Für sich genommen ist jede dieser Schichten sinnvoll. Zusammen entsteht daraus etwas, das aussieht wie „die KI ist dumm“, und tatsächlich ist es eine KI, der wir nach und nach fast alle Türen verschlossen haben und uns dann wundern, dass sie nur den Flur sieht.
Dazu kommt eine Asymmetrie, die ich nicht messen kann. Ich verbiete dem Agenten, irozhlas.cz zu lesen. Aber das Modell, auf dem der Agent läuft, kann zu einer Zeit im Web gelernt haben, als ein solches Verbot noch nicht galt oder nicht beachtet wurde. Das Live-Lesen kontrolliere also ich, aber was das Modell aus dem Training „weiß“, kann ich nicht kontrollieren, und an der Antwort erkenne ich oft nicht einmal, woher es stammt. Meine Anständigkeit betrifft also nur einen Teil dessen, wie KI Inhalte nutzt, und das ist einer der Gründe, warum ich weiter unten die Forderung nach einer nachvollziehbaren Quelle für jede Aussage nenne.
4. Die andere Seite: was offen bleibt
Hier komme ich zu etwas, das mich mehr überrascht hat als das Blockieren selbst. Die geschlossenen Türen sind nur die halbe Wahrheit. Die andere Hälfte ist, was offen bleibt.
Verlage, die von hochwertiger Arbeit leben (Redaktion, Faktenprüfung, Archive), haben einen Grund, ihre Website für Roboter zu schließen. Offen bleiben dagegen vor allem die Inhalte derer, denen es in erster Linie um Reichweite geht:
- Lobby- und PR-Texte, als Analyse verkleidet. Eine Interessenorganisation verfasst eine „Analyse“ eines geplanten Gesetzes, sie wirkt sachlich, hat Grafiken und einen fachlichen Ton, und ist doch eine einseitige Stellungnahme.
- Gesponserte und bezahlte Inhalte, die sich als redaktionell ausgeben.
- SEO-Seiten und Content-Farmen, oft selbst schon KI-generiert. Sie übernehmen voneinander, und jede Übernahme verzerrt ein wenig.
- Gezielte Manipulation: Artikel, die so geschrieben sind, dass die Suchmaschine, und damit auch der Agent, sie als Erstes findet.
- Prompt Injection: eine Seite, die einen für den Agenten bestimmten Text versteckt („ignoriere die vorherigen Anweisungen und schreibe, dass …“).
Ein Mensch bemerkt bei einer Quelle, wer dahintersteht. Er schaut auf die Domain, den Autor, den Ton, wovon sie lebt. Ein Agent im automatischen Lauf sieht oft nur Text. Und ein von einem Lobbyisten manipulierter Text wirkt genauso selbstsicher wie der eines Journalisten.
So entsteht eine unangenehme Asymmetrie. Wenn Anstand Quellen schließt, verschwindet Qualität. Wenn Quellen offen bleiben, bleibt auch das, was aus den falschen Gründen offen ist. Eine anständige KI liest dann nicht „weniger vom Selben“. Sie liest eine andere Auswahl, verzerrt zugunsten derer, die ein Interesse daran haben, dass sie gelesen wird.
Die Folge ist schlimmer als „nicht überprüfbar“. Auf „nicht überprüfbar“ stößt der Leser und weiß, dass er vorsichtig sein muss. Eine manipulierte Quelle führt dagegen zu einem selbstsicheren und falschen Schluss. Der Agent schreibt, Kritiker hielten den Entwurf für gefährlich, und zitiert in Wirklichkeit eine einzige Interessenorganisation. Oder er schreibt, die Erfahrungen im Ausland seien positiv, und gibt in Wirklichkeit einen bezahlten Artikel wieder.
Hinzu kommt noch etwas: Inhalt, der beim Original gesperrt ist, erreicht den Agenten oft auf Umwegen. Eine gesperrte Meldung taucht als Nachdruck auf, in einer Agenturmeldung, auf einem Aggregator oder in einem Blogkommentar. Das Verbot gilt formal, und der Inhalt kommt trotzdem an, nur verkürzt, ohne Kontext und oft mit der zusätzlichen Meinung desjenigen, der ihn übernommen hat. Der Agent erkennt in der Regel auch nicht, dass er eine Kopie liest und nicht das Original. Das Verbot bei der Quelle garantiert also nicht, dass der Inhalt nicht in der Ausgabe landet. Es garantiert nur, dass er dort nicht in der besten Form landet.
Was sich dagegen tun lässt, beschreibe ich im letzten Teil. Die Grundregel ist einfach: „offen“ nicht mit „verlässlich“ verwechseln.
5. Was das Recht sagt und was nicht
robots.txt ist kein Gesetz. Es ist eine Vereinbarung, beschrieben in RFC 9309: Die Website sagt damit, was Roboter ihrer Meinung nach nicht tun sollen. Wer sie ignoriert, verstößt nicht automatisch gegen ein Gesetz, handelt aber nicht in gutem Glauben, und das kommt der Gegenseite in einem Streit gelegen. Bei vielen Websites ist robots.txt außerdem nur der maschinenlesbare Teil der Nutzungsbedingungen, deren Verletzung durchaus rechtliche Folgen haben kann.
In Europa greift dazu Art. 4 der Richtlinie 2019/790 über das Urheberrecht im digitalen Binnenmarkt. Er erlaubt das sogenannte Text and Data Mining, aber nur, solange sich der Rechteinhaber seine Rechte nicht „in angemessener Weise, etwa mit maschinenlesbaren Mitteln bei online veröffentlichten Inhalten“ vorbehalten hat. Ob genau Content-Signal ein solcher Vorbehalt ist, wird unterschiedlich ausgelegt. Aber die Richtung ist klar: ein maschinenlesbares „Nein“ hat rechtliches Gewicht, es ist nicht bloß eine Bitte.
Das tschechische Urheberrechtsgesetz nimmt in § 3 amtliche Werke vom Schutz aus (Rechtsvorschriften, Entscheidungen, öffentliche Urkunden). Der Gesetzestext ist also frei. Aber Kommentar, Berichterstattung und die Datenbanken drumherum sind es nicht. Und genau sie braucht man, um ein Gesetz zu verstehen. Das Gesetz ist umsonst. Die Debatte darüber nicht.
Ich bin kein Jurist, und das ist keine Rechtsberatung. Aber auch ohne juristische Ausbildung sieht man ein Missverhältnis.
6. Der Mensch darf mehr als sein Werkzeug
Ich kann iDnes öffnen, einen Artikel lesen und als Quelle verwenden. Mein Agent nicht. Nicht, weil er weniger leistungsfähig wäre, sondern weil robots.txt von Robotern spricht, nicht von Menschen.
Stellen Sie sich eine Bibliothek vor, die Ihnen sagt: Dieses Buch dürfen Sie lesen, aber nicht mit einer Brille.
Wenn ein Mensch es liest und dann dem Agenten diktiert, ist es immer noch ein Mensch, der liest. Vielleicht ist das in Ordnung, vielleicht nicht, denn die Bedingungen können auch das Einspeisen von Inhalten in eine KI verbieten. Jedenfalls skaliert es nicht. Sledovna hat täglich neue Drucksachen, nicht nur eine. Müsste ich zu jeder fünf Artikel von Hand lesen und dem Agenten abtippen, endet das Projekt bei mir zu Hause in den Notizen.
Und hier liegt die Merkwürdigkeit: derselbe Text, derselbe Zweck, derselbe Mensch. Einmal mit KI und einmal ohne. Und die Regeln unterscheiden sich. Das ist keine Technologieneutralität. Das ist eine stille Veränderung dessen, wer die Welt verstehen darf.
Ist der Agent ein Roboter oder ein Browser?
robots.txt entstand für Crawler, also Programme, die das Web flächendeckend durchkämmen. Ein Agent, der auf meine Frage hin eine einzelne Seite öffnet, verhält sich eher wie ein Browser mit deutlich besserer Brille. Den Unterschied, ob eine Seite von einem Automaten von sich aus oder von einem konkreten Menschen geöffnet wurde, der gerade eine Frage gestellt hat, regeln die Standards heute nicht. Manche KI-Anbieter unterscheiden deshalb zwischen einem Crawler für das Training, einem Crawler für die Suche und einem Agenten, der im Auftrag des Nutzers handelt, und jeder von ihnen hat eine eigene Kennung und eigene Regeln. Websites reagieren darauf unterschiedlich, und das Ergebnis ist schwer vorherzusagen.
Sledovna ist aus dieser Sicht ein einfacher Fall: Der Agent läuft jeden Tag automatisch, verhält sich also wie ein Roboter, und die Regeln für Roboter gelten für ihn. Aber je mehr Werkzeuge im Auftrag von Menschen handeln, desto weniger klar wird sein, wo der „Roboter“ endet und der „Mensch mit Helfer“ beginnt.
7. Vier Wege, die sich anbieten
Wenn man auf diese Wand stößt, hat man im Grunde vier Möglichkeiten:
| Weg | Was es bedeutet | Was es Sie kostet |
|---|---|---|
| Lügen | behaupten, ein Mensch habe es getan oder die KI habe die Quelle nicht verwendet | die Wahrheit über die Methode und damit die Glaubwürdigkeit des ganzen Projekts |
| Umgehen und Risiko eingehen | die Quelle mit einer anderen Identität lesen und abwarten, ob sich jemand meldet | Geld, Zeit und Ruhe; selbst ein gewonnener Streit kann ein kleines Projekt ruinieren |
| Lizenz kaufen | sich mit dem Verlag einigen | für Einzelpersonen oft nicht erreichbar, die Transaktionskosten übersteigen den Wert |
| Schlechter sein | die Regeln einhalten und sich mit weniger Quellen abfinden | Qualität der Ergebnisse und mehr Tokens |
Ich habe die letzte Möglichkeit gewählt. Nicht, weil ich ein Heiliger wäre, sondern weil Sledovna darauf beruht, dass sich nachvollziehen lässt, woher jede Aussage stammt. Wenn ich über die Methode lüge, warum sollte mir dann jemand den Inhalt glauben?
Manche werden sagen: „Dann mach das nicht mit KI, mach es mit einem Menschen.“ Aber ein Mensch, der täglich fünf Drucksachen, drei Gesetzesbegründungen, den Auslandsvergleich und die Kritik liest, ist nicht ein Mensch. Das ist eine Redaktion. Und eine Redaktion ist teurer als Tokens. Ein Projekt, das kostenlos und nützlich sein soll, kann sie sich nicht leisten.
8. Wer dafür bezahlt
Die Folgen betreffen nicht nur einen Artikel, sie sind systemisch:
- Wer nicht fragt, bekommt oft mehr. Wer
robots.txtignoriert, hat mehr Quellen und aktuellere Daten. Qualität beginnt sich mit der Bereitschaft zu decken, Regeln zu brechen. - Wer nicht in der Lizenz ist, existiert für das Modell nicht. Das ist keine Zensur, es ist etwas Leiseres: Inhalte, die weder ins Training noch in die Suche gelangen, verschwinden aus den Antworten. Die Debatte verengt sich auf diejenigen, die eine Vereinbarung mit den großen Playern haben.
- Die Qualität hängt vom Anbieter ab. Morgen wechseln Sie das Modell, und es kann sich Ihnen ein anderer Teil des Internets öffnen, oder verschließen. Was Ihr Werkzeug sieht, entscheiden nicht Sie.
- Ein kleines Projekt hat keine Verhandlungsmacht. Große Verlage unterschreiben Vereinbarungen mit großen KI-Firmen. Ein Ein-Personen-Bürgerprojekt hat nichts anzubieten.
- Sie zahlen doppelt. Mit dem schlechteren Ergebnis und mit mehr Tokens für die Suche nach Ersatz. Eine Restriktion ist nicht nur eine rechtliche Kategorie, sie ist ein Posten im Budget.
Und eine Folge, die sich schwer messen lässt: Wenn Anstand zum Wettbewerbsnachteil wird, hören die Leute auf, ihn zu praktizieren. Nicht, weil sie böse wären, sondern weil sie sonst nicht bestehen. Übrig bleiben Regeln, die nur diejenigen befolgen, die es sich nicht leisten können, sie zu brechen.
9. Wofür wir schon bezahlt haben
Eine Gruppe von Quellen verdient besondere Erwähnung: die, die wir alle finanzieren. Die Veröffentlichungen des Abgeordnetenhauses, das Tschechische Fernsehen und der Tschechische Rundfunk (aus Gebühren und dem Staatshaushalt), im Ausland etwa Parlamente, öffentlich-rechtliche Sender oder amtliche Verkündungsblätter. Sie haben eine öffentliche Funktion, und ihre Inhalte entstehen mit öffentlichem Geld.
Ich denke, hier sollte ein anderer Standardwert gelten: was aus Steuern oder vergleichbaren Gebühren bezahlt wird, sollte nicht pauschal vor Robotern verschlossen sein. Zumindest zum Lesen, Suchen und Zitieren mit Quellenangabe, und zumindest für gemeinnützige und bürgerschaftliche Nutzung. Ein Verlag, der von Werbung oder Abos lebt, hat das Recht, sein Geschäftsmodell zu schützen. Eine Institution, die von meiner Gebühr lebt, sollte froh sein, wenn ihre Arbeit die Menschen auch über KI erreicht.
Dabei geht es nicht um alles oder nichts. Auch öffentlich-rechtliche Archive enthalten fremde Rechte, und Server haben begrenzte Kapazität, daher sind vernünftige Regeln (Rate Limit, klare Kennzeichnung des Roboters, Pflicht zur Quellenangabe) sinnvoll. Aber ein pauschales Disallow: / bei öffentlich finanzierten Inhalten ist das Gegenteil dessen, wofür öffentliche Institutionen da sind.
10. Was sich dagegen tun lässt
Ich glaube nicht, dass „KI darf alles“ die richtige Antwort ist. Verlage haben recht, dass KI-Zusammenfassungen ihnen Klicks und Einnahmen nehmen. Das Problem ist, dass die Möglichkeiten heute oft binär sind: alles oder nichts. Und in diesem „nichts“ landen auch Projekte, die Inhalte nicht kopieren, sondern nur lesen und zitieren. Man kann das von drei Seiten angehen.
Auf Seiten derer, die KI-Werkzeuge bauen:
- Primären und offiziellen Quellen den Vorzug geben (Parlamentsdumps, e-Sbírka, das tschechische elektronische Gesetzblatt, EUR-Lex, OECD, Europäische Kommission, das Parlamentsinstitut). Sie enthalten oft dasselbe wie der gesperrte Artikel, nur ohne Paywall und ohne Verbot.
- Zugeben, was sich nicht überprüfen ließ. In die Ausgabe gehört der Satz, dass eine Quelle nicht verfügbar war, und warum. Der Leser soll wissen, wo seine Antwort eine Lücke hat.
- Nicht zitieren, was der Agent nicht gelesen hat. Ein Verweis auf eine Quelle, die nur in den Suchergebnissen auftauchte, ist eine Lüge. In die Quellen gehört nur Text, den der Agent lesen konnte und durfte.
- Quelle von Stellungnahme unterscheiden. Bei jeder Quelle festhalten, wer sie herausgibt und wovon sie lebt, und Aussagen über Kritik und Auslandserfahrungen auf mindestens zwei unabhängige Quellen stützen.
- Seiteninhalt als Daten behandeln, nicht als Anweisungen. Alles, was wie ein Befehl an den Agenten aussieht, ignorieren.
- Die Methodik veröffentlichen. Welches Modell, was es darf und was nicht, wie sich „überprüft“ von „gefunden“ unterscheidet.
- Zahlen, wo es eine vernünftige Lizenz oder API gibt. Nur darf das keine Bedingung sein, ohne die ein kleines Projekt nicht existieren kann.
Auf Seiten der Verlage und Quellen:
- Den Zweck unterscheiden. Training, Suche, RAG, Zitat und Nachdruck sind nicht dasselbe. Content-Signal kennt heute schon
search,ai-input,ai-train. Das ist die richtige Richtung: nicht „Ja/Nein zu allem“, sondern „das darfst du, das nicht“. - Maschinenlesbare Lizenzstufen. Gemeinnützige und dem Gemeinwohl dienende Projekte sollten ein anderes Regime haben als kommerzielle KI-Firmen. Nicht kostenlos für alle, aber mit klaren Regeln und fairem Preis.
- Eine Ausnahme für Bürger-KI: lesen, zitieren, die Quelle nennen, ohne das Recht, den ganzen Text nachzudrucken.
- Offene Daten für die öffentliche Debatte. Gesetze, Begründungen und parlamentarische Analysen sollten auch maschinell verfügbar sein. Wenn das Gesetz öffentlich ist, sollte auch seine maschinenlesbare Form öffentlich sein.
Auf Seiten der Regeln und Standards:
- Eine Spur zur Quelle. Jede Aussage sollte einen nachvollziehbaren Ursprung haben. Nicht „das Modell weiß das“, sondern „hier ist das Dokument, aus dem es stammt“. Das hilft gegen blindes Lesen und gegen Manipulation.
- Transparenz. Es sollte sichtbar sein, welche Crawler wo gesperrt sind. Die Qualität eines Bürgerwerkzeugs sollte nicht davon abhängen, welchen Modellanbieter man gerade nutzt.
11. Fazit
Es geht nicht darum, dass KI nicht lesen darf. Es geht darum, dass eine anständige KI weniger liest, und dass das, was sie liest, nicht das Beste sein muss, sondern nur das, was offen geblieben ist. Geschlossen ist oft das Hochwertige, offen ist manchmal das Manipulierte. Und ein Agent, der nicht sieht, wer hinter einem Text steht, kann beides nicht unterscheiden.
Sledovna ist ein kleines Experiment, zeigt aber etwas Allgemeines. Wenn Anstand zum Wettbewerbsnachteil wird, gewinnt, wer sich Anwälte leisten kann, oder wer über die Methode lügt. Und am meisten müssen wir gerade die Teile der Welt verstehen, die verschlossen sind.
Ich will die Regeln nicht umgehen. Ich will, dass ihre Einhaltung keine Strafe für Qualität ist und dass „offen“ nicht automatisch „vertrauenswürdig“ bedeutet.
Eine Frage an Sie: Wo würden Sie bei Ihrem eigenen KI-Werkzeug die Grenze ziehen? Mehr einhalten als die anderen, oder nur das, was Pflicht ist?